第一次预测
做完这一节,你会得到七张预测图(每种粒度一张),并且能指着图说出:哪里是历史、哪里是真实走势、哪里是模型画的。
1. 跑默认的七个例子
在 KiT 目录、kit 环境里:
bash
python eval/infer_for_pred.py不带参数时,脚本会跑七个写好的例子,每种粒度一个。我们这里整次用了 57 秒。
你应该看到类似(这里只列 1 小时那一条):
text
[info] loaded EMA weights (step=50000)
device=cuda precision=bf16 K=16 steps=32 solver=euler cfg_w=1.0 hist_cfg_w=1.0 ckpt=step_market_284M.pt
[5/7] 300733.SZ 1h history 2025-09-11 10:30:00 .. 2026-02-09 15:00:00 (400 bars)  predicted 2026-02-10 10:30:00 .. 2026-02-24 15:00:00 (20 bars)
      terminal return actual +4.95%  predicted median +3.37% [q05 +1.04%, q95 +6.64%]  cumulative-return curve corr 0.902  3.7s
...
Plots saved to results/infer_for_pred
step=50000 是检查点里留下的旧字段,官方模型卡说明权重本身没变,不用管。
2. 读懂那一行数字
查一查这一行里的……
点一个看看。
3. 读懂那张图
图在 results/infer_for_pred/,文件名是 代码_粒度_日期.png:
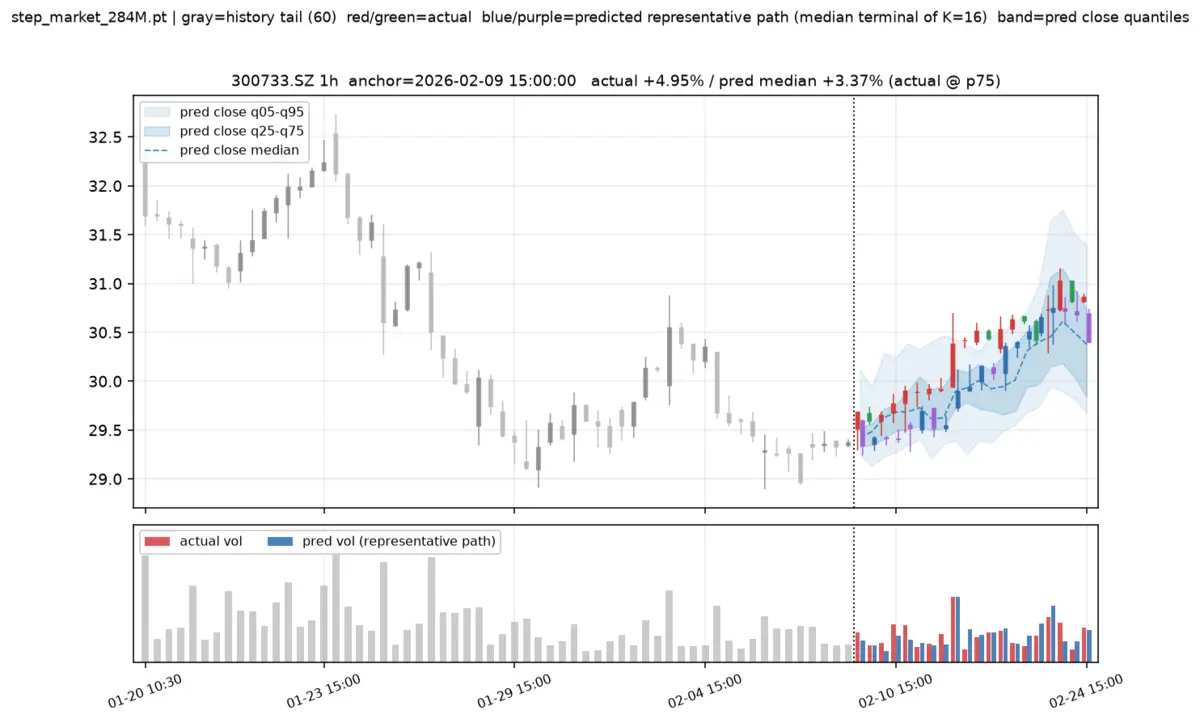
- 灰色 K 线:锚点之前的历史(只画最后 60 根)
- 竖虚线:锚点
- 红绿 K 线:锚点之后真实发生的走势
- 蓝紫 K 线:一条“代表路径”,取 16 条里终点涨跌排在中间的那条
- 深浅两层蓝色带:16 条路径收盘价的 25%~75% 和 5%~95% 范围;虚线是中位数
- 下面的柱子:成交量,红色是真实,蓝色是代表路径的
看图时重点看色带,而不是那一条蓝紫 K 线。色带宽,说明模型自己也觉得这段时间不确定。
4. 预测你自己挑的时间点
一个例子写成 代码,粒度,锚点:
bash
python eval/infer_for_pred.py --case 300368.SZ,1d,2026-01-05 --case 300733.SZ,1h,"2026-02-09 15:00"README 里的例子在演示数据里跑不了
README 写的 601899.SH 和 300750.SZ 不在那 100 只演示股票里,会报:
text
300750.SZ is not in .../data/instruments.json (must be one of the 100 stocks with local data)能用哪些代码,看 data/instruments.json。
5. 为什么两次结果不一样
同一个例子 300368.SZ,1d,2026-01-05,我们单独跑,终点中位数是 −27.28%;放在默认七个例子里第七个跑,是 −21.31%。
原因是随机种子:脚本里第 i 个例子用的种子是 --seed 加 i。种子不同,起点那 16 团噪声不同,画出来的路径就不同。
所以不要拿一次预测的一个数下结论。要看区间,或者加大路径数(下一节会讲)。想让结果完全复现,就固定 --seed,并且例子的顺序也别变。
考考你预测图上的蓝色带很宽,说明什么?
检查一下
results/infer_for_pred/里有 7 张 png 和 7 个 npz- 我能在图上指出锚点、真实走势和预测色带
- 我用
--case预测了一个自己挑的股票和日期
下一节:锚点和窗口。