पहला प्रेडिक्शन
यह सेक्शन पूरा करने पर आपको सात प्रेडिक्शन चार्ट मिलेंगे (हर ग्रैन्युलैरिटी के लिए एक), और आप चार्ट की ओर इशारा करके बता सकेंगे: कौन-सा हिस्सा इतिहास है, कौन-सा असली चाल, और कौन-सा मॉडल ने बनाया है।
1. डिफ़ॉल्ट सात उदाहरण चलाएँ
KiT डायरेक्टरी में, kit एनवायरनमेंट के अंतर्गत:
python eval/infer_for_pred.pyबिना पैरामीटर दिए जाने पर स्क्रिप्ट पहले से लिखे गए सात उदाहरण चलाती है, हर ग्रैन्युलैरिटी के लिए एक। हमने इसे चलाने में कुल 57 सेकंड लगाए।
आपको ऐसा कुछ दिखना चाहिए (यहाँ केवल 1 घंटे वाली पंक्ति दी गई है):
[info] loaded EMA weights (step=50000)
device=cuda precision=bf16 K=16 steps=32 solver=euler cfg_w=1.0 hist_cfg_w=1.0 ckpt=step_market_284M.pt
[5/7] 300733.SZ 1h history 2025-09-11 10:30:00 .. 2026-02-09 15:00:00 (400 bars)  predicted 2026-02-10 10:30:00 .. 2026-02-24 15:00:00 (20 bars)
      terminal return actual +4.95%  predicted median +3.37% [q05 +1.04%, q95 +6.64%]  cumulative-return curve corr 0.902  3.7s
...
Plots saved to results/infer_for_pred
step=50000 चेकपॉइंट में बचा हुआ पुराना फ़ील्ड है, आधिकारिक मॉडल कार्ड के अनुसार वेट बदले नहीं गए हैं, इसे नज़रअंदाज़ करें।
2. संख्याओं की उस पंक्ति को समझें
खोजेंइस लाइन में……
एक पर क्लिक करके देखें।
3. उस चार्ट को समझें
चार्ट results/infer_for_pred/ में है, फ़ाइल का नाम 代码_粒度_日期.png है:
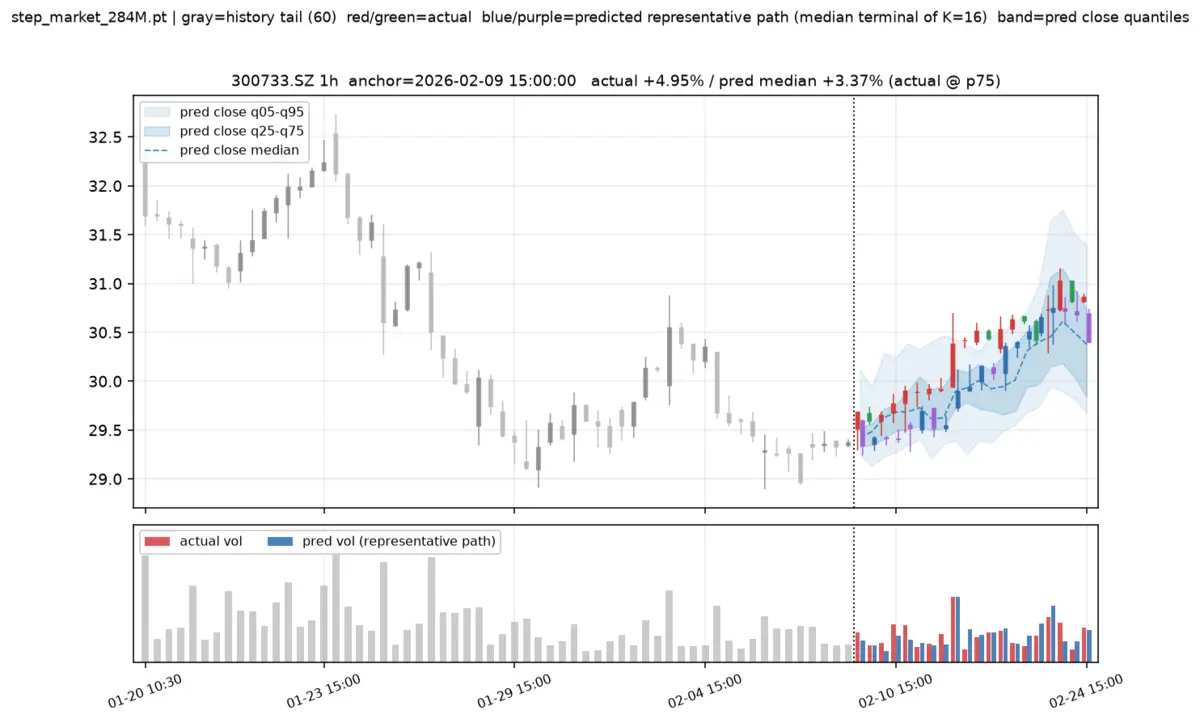
- ग्रे K-लाइन: एंकर से पहले का इतिहास (केवल आख़िरी 60 कैंडल दिखाई गई हैं)
- खड़ी डैश लाइन: एंकर
- लाल-हरी K-लाइन: एंकर के बाद असल में हुई चाल
- नीली-बैंगनी K-लाइन: एक "प्रतिनिधि पथ", 16 पथों में से वह जिसके अंत-बिंदु का उतार-चढ़ाव बीच में है
- गहरे और हल्के दो परतों वाली नीली पट्टी: 16 पथों के क्लोज़ प्राइस की 25%~75% और 5%~95% रेंज; डैश लाइन माध्यिका (मीडियन) है
- नीचे के बार: वॉल्यूम, लाल असली है, नीला प्रतिनिधि पथ का
चार्ट देखते समय उस एक नीली-बैंगनी K-लाइन की बजाय रंगीन पट्टियों पर ध्यान दें। पट्टी चौड़ी होने का मतलब है कि मॉडल ख़ुद भी इस अवधि को अनिश्चित मानता है।
4. आपके चुने हुए समय-बिंदु का प्रेडिक्शन करें
एक उदाहरण 代码,粒度,锚点 के रूप में लिखा जाता है:
python eval/infer_for_pred.py --case 300368.SZ,1d,2026-01-05 --case 300733.SZ,1h,"2026-02-09 15:00"README का उदाहरण डेमो डेटा पर नहीं चल सकता
README में लिखे 601899.SH और 300750.SZ उन 100 डेमो स्टॉक में नहीं हैं, त्रुटि आएगी:
300750.SZ is not in .../data/instruments.json (must be one of the 100 stocks with local data)कौन-से कोड उपयोग किए जा सकते हैं, यह data/instruments.json में देखें।
5. दो बार का नतीजा अलग क्यों
एक ही उदाहरण 300368.SZ,1d,2026-01-05, जिसे हमने अलग से चलाया, उसकी अंत-बिंदु माध्यिका −27.28% है; डिफ़ॉल्ट सात उदाहरणों में सातवें स्थान पर चलाने पर −21.31% आई।
कारण यादृच्छिक बीज (random seed) है: स्क्रिप्ट में i-वें उदाहरण के लिए इस्तेमाल होने वाला बीज --seed जोड़ i होता है। बीज अलग होने पर शुरुआती उस 16 नॉइज़ के समूह के कारण बनने वाला रास्ता अलग होता है, और इसलिए प्लॉट किया गया पथ भी अलग होता है।
इसलिए एक बार की भविष्यवाणी के एक आँकड़े से निष्कर्ष मत निकालें। अंतराल देखें, या पथों की संख्या बढ़ाएँ (अगला सेक्शन इसके बारे में बताएगा)। चाहते हैं कि परिणाम पूरी तरह दोहराए जा सकें, तो --seed को नियत रखें, और उदाहरणों का क्रम भी न बदलें।
आपकी परीक्षाप्रेडिक्शन चार्ट पर नीली पट्टी चौड़ी है, इसका क्या मतलब है?
एक बार जाँच लें
results/infer_for_pred/में 7 png और 7 npz हैं- मैं ग्राफ़ पर एंकर पॉइंट, वास्तविक रुझान और भविष्यवाणी का रंगीन बैंड पहचान सकता/सकती हूँ
- मैंने
--caseके साथ अपनी पसंद का एक स्टॉक और तारीख़ चुनकर भविष्यवाणी की
अगला सेक्शन: एंकर पॉइंट और विंडो।