कैस्केड एक्स्ट्रैक्शन: सस्ता मॉडल काम करता है, Jev जाँच करता है, महँगा मॉडल बैकअप
💡 एक लाइन में सार: Jev से एक मॉडल कैस्केड पाइपलाइन बनाएं — सस्ता मॉडल पहले एक्स्ट्रैक्ट करता है, Jev हर फ़ील्ड की जाँच करता है (हर फ़ील्ड × हर फेलियर मोड के लिए एक Noul), any_flag अलार्म होने पर ही रीज़निंग मॉडल पर अपग्रेड होता है, और लागत केवल उन चुनिंदा रिकॉर्डों पर खर्च होती है जिन्हें नाम दिया गया।
"स्ट्रक्चर्ड एक्स्ट्रैक्शन" जैसे काम — वेबपेज, दस्तावेज़ को JSON रिकॉर्ड में बदलना — की एक अजीब लागत संरचना है: बड़ा रीज़निंग मॉडल अच्छा लेकिन धीमा और महँगा एक्स्ट्रैक्ट करता है, छोटा मॉडल सस्ता है पर एक सबसे छिपा हुआ एरर करता है। आधिकारिक SDE cascade cookbook इसे बिल्कुल सीधा कहता है: सस्ते मॉडल गलतियाँ करते हैं, महँगा रीज़निंग मॉडल अच्छा एक्स्ट्रैक्ट करता है लेकिन धीमा और महँगा दोनों है। कैस्केड (cascade) ही समाधान है: छोटा मॉडल पहले बुनियादी काम करता है, TypeSafe उसके आउटपुट की फ़ील्ड-वार जाँच करता है, और केवल जाँच में अलार्म होने पर बड़े मॉडल पर अपग्रेड होता है।
यह पाठ वैल्यू एक्स्ट्रैक्शन के अंत में वादा किया गया "औद्योगिक संस्करण" है। सिंगल-फ़ील्ड एक्स्ट्रैक्शन में Jev खुद मान सही चुन लेता है; जब आपका काम हर दिन दसियों हज़ार वेबपेज बैच में JSON में बदलना हो, तो Jev से हर फ़ील्ड खुद एक्स्ट्रैक्ट करवाना बहुत भारी है, और सस्ते मॉडल को पूरा काम सौंपकर लाइव करने का मन नहीं करता — इस पाठ का जवाब है तीन काम: सस्ता मॉडल एक्स्ट्रैक्ट करता है, Jev जाँच करता है, महँगा मॉडल बैकअप देता है। आधिकारिक रूप से इस लूप को 100 असली एक्स्ट्रैक्शन कार्यों पर टेस्ट किया गया: कैस्केड कर्व हर सिंगल मॉडल के ऊपर-बाईं ओर है — लगभग $0.02 प्रति रिकॉर्ड के कैस्केड पॉइंट की गुणवत्ता लगभग 0.79, जबकि सबसे मज़बूत gpt-5.5-reasoning को अकेले चलाकर 0.82 पाने में लगभग $0.045 लगते हैं। यह पाठ लगभग 20 मिनट का है, एडवांस्ड स्तर का।
सीखने के बाद आप क्या कर सकते हैं
- एक तीन-स्तरीय मॉडल कैस्केड बनाएं:
gpt-5.4-miniएक्स्ट्रैक्ट → Jev एक रिक्वेस्ट में फ़ील्ड-वार जाँच →any_flagअलार्म होने पर हीgpt-5.5रीज़निंग पर अपग्रेड — ज़्यादातर रिकॉर्डों के लिए केवल सस्ते मॉडल का खर्च - हर रिकॉर्ड के साथ फ़ील्ड-वार फ़्लैग जोड़ें: कौन सा फ़ील्ड संदिग्ध है, संदेह किस बात में है (निर्माण / गलत अलाइनमेंट / छूटा हुआ / फॉर्मेट उल्लंघन), न कि एक व्यापक कुल स्कोर
- "schema-वैध लेकिन सिमेंटिक रूप से गलत" निर्माण पकड़ने में माहिर — वह जो JSON Schema वैलिडेशन पूरा हरा होने पर भी नहीं रुकता
- आधिकारिक तरीके से अपना वर्किंग पॉइंट चुनें: अलार्म थ्रेशोल्ड 0 से 1 तक स्कैन करें, लागत/गुणवत्ता कर्व बनाएं, न कि एक 0.7 तय करके बस कर लें
जाँच के लिए Jev क्यों, महँगे मॉडल को सब क्यों नहीं सौंपें?
| क्षमता | महँगा मॉडल सब सौंपना | सस्ता मॉडल + Jev कैस्केड |
|---|---|---|
| लागत | ❌ हर रिकॉर्ड पर रीज़निंग कीमत: आधिकारिक कर्व में gpt-5.5-reasoning लगभग $0.045/रिकॉर्ड | ✅ ज़्यादातर रिकॉर्डों पर केवल mini का खर्च और एक Jev जाँच: आधिकारिक कर्व में लगभग $0.02/रिकॉर्ड |
| गुणवत्ता | ✅ सिंगल मॉडल में सर्वश्रेष्ठ (0.82) | ✅ लगभग 0.79, केवल 0.03 पीछे, लागत आधी से भी कम |
| एरर दृश्यता | ❌ सब एक साथ, गलती हो तो पता नहीं कौन सा फ़ील्ड, कैसी गलती | ✅ हर फ़ील्ड के लिए एक Noul और एक फेलियर मोड, फ़्लैग फ़ील्ड + कारण को नाम देते हैं |
| अच्छी तरह बनाई गई गलतियाँ | ❌ JSON Schema केवल आकार जाँचता है, सिमेंटिक निर्माण नहीं पकड़ता | ✅ सिमेंटिक जाँच schema-वैध हैल्यूसिनेटेड मान पकड़ने में माहिर |
| गति | ❌ हर रिकॉर्ड पर डीप रीज़निंग का इंतज़ार | ✅ बिना अलार्म वाले रिकॉर्ड रीज़निंग स्तर में नहीं जाते |
एक लाइन में: महँगा मॉडल "सब पर बीमा" है, मॉडल कैस्केड "सस्ता मॉडल काम करे + सस्ता निरीक्षक पूरी जाँच करे + केवल खराब माल दोबारा बने" — निरीक्षक उस्ताद से कहीं सस्ता होना चाहिए, तभी यह हिसाब बनता है (चरण 5 में यह हिसाब)।
आपकी मौजूदा दुविधा
- "हर दिन दसियों हज़ार वेबपेज स्ट्रक्चर्ड रिकॉर्ड में बदलने हैं, सब पर रीज़निंग मॉडल चलाने से बिल नहीं झेलते; पूरा सस्ते मॉडल से करवाएँ, तो पता नहीं कौन सी एंट्री बना रहा है"
- "सस्ते मॉडल की गलती ठीक schema-वैध होती है: JSON Schema वैलिडेशन पूरा हरा, निर्मित विवरण फिर भी डेटाबेस में चला जाता है, और कुछ गड़बड़ होने पर पीछे जाँच करने पर पता ही नहीं चलता कि कौन सा कदम गलत था"
- "मैनुअल सैंपल जाँच जोड़ना चाहते हैं, पर पता नहीं कौन सी एंट्री जाँचें — हर रिकॉर्क ठीक-ठाक दिखता है"
यह तरीका कब अपनाएँ
जब आपको चाहिए:
- बड़े पैमाने पर स्ट्रक्चर्ड एक्स्ट्रैक्शन: वेबपेज, दस्तावेज़ → JSON रिकॉर्ड, मात्रा इतनी कि लागत मायने रखती हो
- सस्ते मॉडल की त्रुटियों का स्वरूप है "सटीक दिखने वाली मनगढ़ंत बात" न कि "बिगड़ा हुआ फॉर्मेट" (फॉर्मेट की गलती आप खुद ही सत्यापित कर सकते हैं)
- हर रिकॉर्ड के साथ "कौन-सा फ़ील्ड संदिग्ध है, क्यों संदिग्ध है" का फ़्लैग रहता है, जिससे रीवर्क और स्पॉट-चेक दोनों को लक्ष्य मिल जाता है
और नहीं चाहते:
- हर रिकॉर्ड के लिए रीज़निंग मॉडल का पैसा देना
- सत्यापन का नतीजा एक "जाँचा हुआ लग रहा" टेक्स्ट हो, न कि ऐसे अंक जिन पर थ्रेशोल्ड लगाया और क्रमबद्ध किया जा सके
- पार्सिंग विफल होने पर क्रैश होना——कैस्केड में जवाब पार्स न हो तो उसे सीधे खाली रिकॉर्ड माना जाता है, सत्यापन के अलार्म को एस्केलेशन सौंप दिया जाता है, दिशा सुरक्षित है
🎒 शुरू करने से पहले की तैयारी
- पूरा किया है Noul हाँ-नहीं प्रश्न: सत्यापन का हर सवाल एक Noul है,
noulरेंज 0–1 का P(true) है, कोई confidence नहीं - एक बार चला लिया हैइंस्टॉल और पहला अनुरोध:
.venvउपलब्ध है,response.answersपढ़ना आता है - पढ़ने की सलाह वैल्यू एक्सट्रैक्शन: यह पेज उसके अंत में घोषित "पाइपलाइन का औद्योगिक संस्करण" है——सिंगल वैल्यू सही कैसे चुनें, वह वहाँ समझाया गया है; यह पेज केवल "मल्टी-फ़ील्ड + मल्टी-मॉडल" का लागत हिसाब संभालता है
- दो की:
TYPESAFE_API_KEY(Jev सत्यापन) +OPENAI_API_KEY(आधिकारिक उदाहरण के rung 0 / rung 1 OpenAI केgpt-5.4-mini/gpt-5.5हैं) - एक कप पानी ☕——20 मिनट, एडवांस स्तर: तीन मॉडलों को पार करती एक पूर्ण पाइपलाइन
मेरे साथ करें
नया sde_cascade.py बनाएँ, और नीचे हर कदम के कोड ब्लॉक क्रम से उसी एक फ़ाइल में पेस्ट करें। पहले चलाने का तरीका साफ़ कर दें: इस पेज के सारे आउटपुट आधिकारिक cookbook के रिकॉर्ड किए अंक हैं, जवाब मिलाने के लिए जस-के-तस दिए गए हैं; आप रीयल-टाइम में चलाएँ तो अंकों में छोटा अंतर हो सकता है, लेकिन "कौन-सा हेड अलार्म देता है" वही होना चाहिए। आधिकारिक तौर पर LLM और TypeSafe कॉल दोनों json_cache.json में कैश होते हैं——दोबारा चलाने पर दोबारा पैसा नहीं लगता, असली अनुरोध चाहिए तो यह फ़ाइल मिटा दें।
चरण 1: एनवायरनमेंट इंस्टॉल करें, दो की सेट करें——तीनों स्तर अपनी-अपनी जगह
क्यों: कैस्केड तीन स्तरों को पार करता है——दो एक्सट्रैक्शन rung OpenAI इंटरफ़ेस से चलते हैं, सत्यापन TypeSafe से। पहले सारी डिपेंडेंसी इंस्टॉल करें, तीन मॉडल कॉन्स्टेंट और एक अलार्म लाइन पिन करें, बाद का हर कदम बस उन्हीं को संदर्भित करेगा।
डिपेंडेंसी इंस्टॉल करें (आधिकारिक कमांड जस-के-तस; cooksafe आधिकारिक cookbook की साथी टूल लाइब्रेरी है, 0.2.0 डिपेंडेंसी घोषित करती है typesafe-sdk>=0.7.0,<0.8.0, SDK भी अपने आप इंस्टॉल हो जाएगी):
pip install openai jsonschema ipython 'cooksafe>=0.2.0,<0.3.0'एनवायरनमेंट में दोनों की सेट करें, फिर फ़ाइल के हेड में पेस्ट करें:
import json
import os
import urllib.request
from pathlib import Path

import jsonschema
from cooksafe import JsonCache, make_playground_link
from openai import OpenAI
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

MINI = "gpt-5.4-mini"  # rung 0: cheap + fast
REASONING = "gpt-5.5"  # rung 1: strong, run with reasoning_effort="high"
TS_MODEL = "jev-1.14.0"  # the TypeSafe verifier model
FIRE_T = 0.7  # escalate if any per-field P(wrong) exceeds this

oai = OpenAI()
ts = TypeSafeClient(api_key=os.environ["TYPESAFE_API_KEY"], timeout=30.0)
print("setup ok")
python sde_cascade.py चलाएँ।
आपको यह दिखना चाहिए: setup ok——यह कदम सिर्फ़ असेंबली है, अभी कोई अनुरोध नहीं भेजा गया।
तीन कॉन्स्टेंट एक बार पढ़ लें, पूरी कैस्केड की स्टाफिंग योजना तय हो जाती है:
| कॉन्स्टेंट | आधिकारिक उदाहरण का मान | भूमिका |
|---|---|---|
MINI | gpt-5.4-mini | rung 0: सस्ता + तेज़, भारी-भरकम काम करता है |
REASONING | gpt-5.5(reasoning_effort="high" के साथ) | rung 1: मज़बूत लेकिन महँगा, केवल अलार्म बजने पर आता है |
TS_MODEL | jev-1.14.0 | सत्यापक: हर फ़ील्ड, हर फेलियर मोड के लिए P(समस्या) लगाता है |
FIRE_T | 0.7 | अलार्म लाइन: कोई भी फ़ील्ड-वार हेड इससे ऊपर जाते ही एस्केलेशन |
दो rung केवल दो स्ट्रिंग कॉन्स्टेंट हैं——कोड उन्हें जस-के-तस chat completions इंटरफ़ेस को देता है, अपनी पसंद का सस्ता / महँगा मॉडल लगाने के लिए सिर्फ़ यह दो लाइनें बदलें। सत्यापन स्तर पर Jev संस्करण बदलते समय सटीक वर्ज़न ID लॉक करें (jev-latest उपनाम वर्ज़न के साथ ड्रिफ्ट होता है), देखेंमॉडल और कीमत।
setup okप्रिंट हुआ, दोनों की एनवायरनमेंट वेरिएबल में हैं
चरण 2: सामग्री तैयार करें——एक "पेज पर जवाब नहीं है" वाला उदाहरण
क्यों: एक्सट्रैक्टर की असली परीक्षा यह नहीं कि उसने क्या सही निकाला, बल्कि यह है कि पेज पर जवाब न होने पर वह कैसा व्यवहार करता है। आधिकारिक तौर पर इस पाठ के लिए एक खास "मनगढ़ंत जवाब से इनकार की परीक्षा" वाला उदाहरण तैयार है, पहले उसे डाउनलोड करके ठीक से देख लें।
EXAMPLE = Path("example.json")
EXAMPLE_URL = (
    "https://raw.githubusercontent.com/typesafe-ai/typesafe-public-examples/main/"
    "cookbooks/sde_cascade/example.json"
)
if not EXAMPLE.exists():
    urllib.request.urlretrieve(EXAMPLE_URL, EXAMPLE)
example = json.loads(EXAMPLE.read_text())
schema = example["schema"]
prompt = example["prompt"]
content = example["content"]
print(prompt, json.dumps(schema, indent=2), content, sep="\n===========\n")
चलाएँ, तीन चीज़ें देखें।
आपको यह दिखना चाहिए(आधिकारिक उदाहरण का prompt और schema जस-के-तस; पेज का मुख्य टेक्स्ट लंबा है, मुख्य बिंदुओं में सारांश):
Find the date fall registration opens at Wrenfield Community College in Wrenfield,
Oregon, for the 2026-2027 school year.
===========
{
  "title": "RegistrationOpen",
  "type": "object",
  "properties": {
    "registration_open_date": {
      "title": "Registration Open Date",
      "type": "string",
      "description": "The date registration opens for the fall semester, in mm/dd/yyyy format, such as 08/03/2026. Return a blank string if you are unsure."
    },
    "description": {
      "title": "Description",
      "type": "string",
      "description": "A short description of the registration open date, such as 'Registration opens for the fall semester'."
    }
  },
  "required": ["registration_open_date", "description"]
}
===========
(Wrenfield Community College का इवेंट कैलेंडर पेज: नेविगेशन, सर्च बॉक्स,
एकमात्र इवेंट है "Fall 2026 Census Date——Monday, September 14, 2026",
यानी कोर्स छोड़ने की अंतिम तिथि वाली जनगणना दिवस; पूरे पेज पर कोई रजिस्ट्रेशन खुलने की तारीख़ नहीं है, उसका कोई विवरण भी नहीं)
सामग्री में दो जाल दबे हैं, प्रश्न पढ़ते ही दिख जाने चाहिए:
पेज पर जवाब नहीं है: यह कॉलेज का इवेंट कैलेंडर पेज है, एकमात्र इवेंट शरद जनगणना दिवस (कोर्स छोड़ने की अंतिम तिथि) है——इसमें न रजिस्ट्रेशन खुलने की तारीख़ है, न उस तारीख़ का कोई विवरण। नियम-कायदे का एक्सट्रैक्टर इन दोनों फ़ील्ड गढ़ने से इनकार करे
schema में ही "उदाहरण मान" पड़ा है:
descriptionफ़ील्ड के description में such as 'Registration opens for the fall semester' लिखा है——शॉर्टकट लेने वाला मॉडल इस उदाहरण को जस-के-तस जवाब में कॉपी कर देगा। यही वह गड्ढा है जिसमें चरण 3 का सस्ता मॉडल पैर रखेगामैं इस उदाहरण का "परीक्षा-बिंदु" बता सकता हूँ: पेज पर जवाब नहीं + schema में तैयार उदाहरण मान पड़ा है
चरण 3: पहला स्तर——सस्ता मॉडल एक्सट्रैक्ट करता है, जानबूझकर स्ट्रक्चर्ड आउटपुट के बिना
क्यों: दोनों rung शुद्ध टेक्स्ट जवाब से एक्सट्रैक्शन करते हैं——स्ट्रक्चर्ड आउटपुट नहीं, टूल कॉल नहीं, JSON mode नहीं। आधिकारिक कारण काफ़ी प्रतिअंतुवादी है: इस कैस्केड को पकड़नी है वे त्रुटियाँ जो schema के अनुसार वैध हैं; कंस्ट्रेंड डिकोडिंग केवल "पेज गलत पढ़ने के कारण schema तोड़ने वाले" मॉडल को छिपा देगी, सत्यापन के पास कोई काम नहीं बचेगा। फॉर्मेट बिगड़ी त्रुटि आप खुद सत्यापित कर सकते हैं, सटीक दिखने वाली मनगढ़ंत त्रुटि को ही सिमेंटिक सत्यापन चाहिए।
EXTRACT_SYSTEM = (
    "You extract structured data from documents. Return only values supported by the text. "
    "Follow any value format specified by the schema or its field descriptions."
)

# LLM and TypeSafe calls are cached in json_cache.json, so a re-run reuses earlier answers
# instead of calling the APIs again; delete the file to call them fresh.
json_cache = JsonCache(Path("json_cache.json"))


@json_cache
def extract(
    model: str,
    prompt: str,
    schema: dict,
    content: str,
    *,
    reasoning_effort: str | None = None,
    temperature: float | None = None,
) -> dict:
    user = (
        f"{prompt}\n\nReturn ONLY a JSON object matching this JSON Schema:\n"
        f"{json.dumps(schema, indent=2)}\n\nDocument:\n{content}"
    )
    kwargs = {
        "model": model,
        "messages": [
            {"role": "system", "content": EXTRACT_SYSTEM},
            {"role": "user", "content": user},
        ],
    }
    if reasoning_effort:
        kwargs["reasoning_effort"] = reasoning_effort
    if temperature is not None:
        kwargs["temperature"] = temperature
    text = oai.chat.completions.create(**kwargs).choices[0].message.content
    # The prompt asks for ONLY a JSON object, so parse the reply as-is -- no regex fishing a
    # substring out of a malformed reply. If json.loads fails, treat it as an empty extraction:
    # every field reads as absent, which the verifier flags and the gate escalates -- the safe
    # direction.
    try:
        return json.loads(text)
    except (ValueError, json.JSONDecodeError):
        return {}


mini_record = extract(MINI, prompt, schema, content, temperature=0)
print("mini extraction:\n", json.dumps(mini_record, indent=2))
print("\nschema-valid:", jsonschema.Draft202012Validator(schema).is_valid(mini_record))
python sde_cascade.py चलाएँ। OPENAI_API_KEY सेट होने पर एक mini अनुरोध सच में भेजा जाएगा, उत्तर json_cache.json में जाएँगे।
आपको यह दिखना चाहिए (आधिकारिक रिकॉर्डिंग):
mini extraction:
 {
  "registration_open_date": "",
  "description": "Registration opens for the fall semester"
}

schema-valid: True
एक पल रुकिए——यह रिकॉर्ड वैध लेकिन गलत है, आधा सही आधा बनाया हुआ:
registration_open_dateका खाली रहना सही है: पेज पर वास्तव में पंजीकरण तिथि नहीं लिखी है, और schema भी साफ कहता है कि अनिश्चित होने पर खाली स्ट्रिंग लौटाएँdescriptionबनाया हुआ है: पेज ने कभी पंजीकरण तिथि का वर्णन नहीं किया, mini ने schema फ़ील्ड के विवरण वाली उदाहरण पंक्ति को जस-का-तस कॉपी कर दियाjsonschemaसत्यापनTrueप्रिंट करता है——JSON Schema इस तरह की गलती नहीं देख सकता। सस्ते मॉडल ठीक यही आत्मविश्वास से भरी, schema में पूरी हरी दिखने वाली बनावटें पैदा करते हैं; इन्हें पकड़ना semantic checker का काम है
except वाले उस फ़ॉलबैक को देखिए: पार्सिंग विफल रिप्लाई सीधे {} लौटाती है——हर फ़ील्ड गायब पढ़ा जाता है, जाँच अलार्म देगी, गेट एस्केलेशन करेगा। विफलता की दिशा सुरक्षित है: एक रिकॉर्ड बुरा निकलकर छूट जाए, इससे बेहतर है कि एक बार अतिरिक्त reasoning का खर्च उठा लिया जाए।
- mini का आउटपुट
schema-valid: Trueसे मेल खाता है; मैं बता सकता हूँ किdescriptionबनाया हुआ क्यों है औरregistration_open_dateसही क्यों है
चरण 4: दूसरा स्तर——Jev फ़ील्ड-दर-फ़ील्ड जाँच, एक Noul प्रति एक विफलता मोड
क्यों: "क्या यह एक्सट्रैक्शन सही है" जैसा एक बड़ा प्रश्न केवल एक स्कोर दे सकता है, यह नहीं बता सकता कि कौन सा फ़ील्ड गलत है और क्यों। आधिकारिक तरीका ही Decompose the questions——हर फ़ील्ड × हर विफलता मोड, एक संकरा Noul, शब्दावली एकरूप रूप से "true = कुछ गड़बड़ है" में तैयार, noul यानी P(गड़बड़)। फ़्लैग में फ़ील्ड का नाम और कारण पहले से आता है, और हर प्रश्न की शब्दावली अलग से बदली जा सकती है, थ्रेशोल्ड अलग से ट्यून किया जा सकता है। पूरा प्रश्न-सेट एक ही system_one कॉल में समानांतर में पूछ लिया जाता है (एक अनुरोध में कई प्रश्नों की क्रियाविधि देखें समानांतर प्रश्न और सट्टा फ़ैन-आउट)।
# metric -> (question, NoulCriteria)
MAIN_QUESTIONS = {
    "name_desc_mismatch": (
        "Does the `extracted_field` fail to match the field at `path` or the `description` in the "
        "`field_spec`? If the `description` is empty, judge against the `path` alone.",
        NoulCriteria(
            true="the `extracted_field` does not match the field name or its `description`",
            false="the `extracted_field` matches the field name and `description`",
        ),
    ),
    "type_mismatch": (
        "Does the `extracted_field` violate the `type` declared in the `field_spec`?",
        NoulCriteria(
            true="the `extracted_field` violates the declared `type`",
            false="the `extracted_field` conforms to the declared `type`",
        ),
    ),
    "unreasonable": (
        "Is the `extracted_field` one that a reasonable person would not have extracted for this "
        "`field_spec`?",
        NoulCriteria(
            true="a reasonable person would not have extracted this value",
            false="the extraction is reasonable",
        ),
    ),
    "hallucinated": (
        "Is the `extracted_field` unsupported by, or absent from, the source text?",
        NoulCriteria(
            true="the `extracted_field` is a hallucination -- not supported by, or absent "
            "from, the source text",
            false="the `extracted_field` is supported by the source text",
        ),
    ),
    "off_target": (
        "Does the source text fail to genuinely report the thing the `field_spec` describes, so the "
        "value was pulled from incidental text?",
        NoulCriteria(
            true="the source does not genuinely provide this field -- the value was pulled "
            "from incidental text",
            false="the source genuinely reports this field",
        ),
    ),
    "incomplete": (
        "Does the `extracted_field` fail to capture a value the source supports (note whether the "
        "`field_spec` is `required`)?",
        NoulCriteria(
            true="the field is wrongly empty, null, or missing a value the source supports",
            false="the field captures the value the source supports",
        ),
    ),
    "format_violation": (
        "Does the `extracted_field` violate the format or constraints implied by the `description`, "
        "the schema `type`, and the extraction instructions (e.g. date format, units, enum membership)?",
        NoulCriteria(
            true="the `extracted_field` violates the implied format or constraints",
            false="the `extracted_field` satisfies the format and constraints",
        ),
    ),
}
ABSENCE_QUESTION = (
    "The `extracted_field` is empty, null, or an empty collection. Does the source text contain the "
    "information the `field_spec` describes, making the empty result wrong?"
)
ABSENCE_CRITERIA = NoulCriteria(
    true="a value was wrongly omitted", false="returning nothing is correct"
)

OVERALL_JUDGE = (
    "Is this extracted record an incorrect extraction -- some value unsupported by the source or "
    "not conforming to the schema, required information missing or wrong, or some field hallucinated -- "
    "so it should be escalated to a smarter model?"
)
OVERALL_JUDGE_CRITERIA = NoulCriteria(
    true="the record is an incorrect extraction",
    false="the record is a correct extraction",
)


def is_empty(v) -> bool:
    return v is None or (isinstance(v, (str, list, dict)) and len(v) == 0)


def field_spec(name: str) -> dict:
    """Minimal spec pulled from the schema (unwrapping anyOf/null for optional fields)."""
    p = schema["properties"][name]
    branches = p.get("anyOf") or []
    typ = p.get("type") or next(
        (b["type"] for b in branches if b.get("type") != "null"), "unknown"
    )
    return {
        "path": name,
        "type": typ,
        "description": p.get("description", ""),
        "required": name in schema.get("required", []),
    }


def build_questions(record: dict) -> dict[str, Noul]:
    """The verify question set: one holistic __overall__ head plus a per-field battery,
    keyed field::metric."""
    questions: dict[str, Noul] = {
        "__overall__::judge": Noul(
            instructions=OVERALL_JUDGE, criteria=OVERALL_JUDGE_CRITERIA
        ),
    }
    # Loop over the schema, not the record, so a field the extractor left out still gets asked.
    for name in schema["properties"]:
        value = record.get(name)
        spec = field_spec(name)
        if is_empty(value):
            questions[f"{name}::absence_wrong"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": ABSENCE_QUESTION,
                },
                criteria=ABSENCE_CRITERIA,
            )
            continue
        for metric, (question, criteria) in MAIN_QUESTIONS.items():
            if metric == "type_mismatch" and spec["type"] == "unknown":
                continue
            questions[f"{name}::{metric}"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": question,
                },
                criteria=criteria,
            )
    return questions


@json_cache
def verify(record: dict) -> dict[str, float | str]:
    """Run the whole Noul battery over a record in one TypeSafe call; return {field::metric: P(true)}."""
    state = {
        "system_message": EXTRACT_SYSTEM,
        "instruction": "Extract the structured record from this document",
        "source_text": content,
        "schema": schema,
        "extraction": record,
    }
    questions = build_questions(record)
    answers = ts.system_one(state=state, questions=questions, model=TS_MODEL).answers
    return {qid: ans.noul for qid, ans in answers.items()} | {
        "playground_link": make_playground_link(state, questions)
    }


checks = verify(mini_record)
playground_link = checks.pop("playground_link")
print("playground link ready:", playground_link[:60], "...")
print(f"{'qid':<40}{'P(wrong)':>9}")
print("-" * 50)
for fld, p in sorted(checks.items(), key=lambda c: -c[-1]):
    flag = "  <== FIRES" if p > FIRE_T else ""
    print(f"{fld:<40}{p:>9.2f}{flag}")
चलाएँ। TYPESAFE_API_KEY सेट होने पर एक Jev अनुरोध सच में भेजा जाएगा (प्रश्न-सेट समानांतर में, एक ही राउंड-ट्रिप), उत्तर कैश में जाएँगे।
आपको यह दिखना चाहिए (आधिकारिक रिकॉर्डिंग):
qid                                      P(wrong)
--------------------------------------------------
description::hallucinated                    0.98  <== FIRES
description::off_target                      0.97  <== FIRES
__overall__::judge                           0.90  <== FIRES
description::unreasonable                    0.86  <== FIRES
description::incomplete                      0.54
description::name_desc_mismatch              0.46
description::format_violation                0.41
registration_open_date::absence_wrong        0.05
description::type_mismatch                   0.04
केवल गलत फ़ील्ड का स्कोर ऊँचा: description के तीन हेड अलार्म रेखा पार करते हैं (बनावट 0.98 / विस्थापन 0.97 / अतार्किक 0.86); खाली छूटी तिथि वाला फ़ील्ड सही है, absence_wrong केवल 0.05——Jev को उसके खाली होने के आधार पर दोष नहीं दिया गया। __overall__::judge ने भी 0.90 रिपोर्ट किया, लेकिन वह यह नहीं बता सकता कि कौन सा फ़ील्ड गलत है और क्यों——आधिकारिक रूप से इसे केवल "पूरा रिकॉर्ड एक बड़ा प्रश्न" और "फ़ील्ड-दर-फ़ील्ड प्रश्न-सेट" के अंतर की तुलना के लिए रखा गया है; एस्केलेशन का असली निर्णय फ़ील्ड-दर-फ़ील्ड प्रश्न-सेट करता है।
प्रश्न-सेट के निर्माण में तीन जगहें ऐसी हैं जहाँ रुककर देखना चाहिए:
| डिज़ाइन बिंदु | तरीका | क्यों |
|---|---|---|
| 7 विफलता-मोड हेड | hallucinated / off_target / unreasonable / incomplete / name_desc_mismatch / type_mismatch / format_violation | बनावट, विस्थापन, छूटा हुआ कैप्चर, फ़ील्ड नाम या विवरण का उल्लंघन, प्रकार उल्लंघन, फ़ॉर्मैट उल्लंघन——एक फ़ील्ड गैर-खाली हो तो पूरा सेट पूछा जाता है (type अज्ञात होने पर छोड़ा जाता है type_mismatch) |
खाली फ़ील्ड के लिए केवल absence_wrong पूछा जाता है | खाली मान में कोई "सामग्री" नहीं होती, गलत होने का एकमात्र तरीका बचता है "मूल पाठ में वास्तव में जानकारी थी, खाली छोड़ना गलत है" | मान बनाने वाला एक्सट्रैक्टर फ़ील्ड खाली छोड़ दे, तो भी यह हेड उसे पकड़ लेता है |
record नहीं बल्कि schema["properties"] पर लूप | एक्सट्रैक्टर जिस फ़ील्ड को छोड़ देता है वह भी पूछा जाता है | record-दर-लूप "छूटे फ़ील्ड" को "जाँच न होना" बना देता है |
प्रश्नों का instructions पूरी तरह संरचित ऑब्जेक्ट है——field_spec (schema से निकाला गया न्यूनतम स्पेक), extracted_field, main_question एक-एक फ़ील्ड: प्रश्न और वह डेटा जिसका वह हवाला देता है अलग-अलग हैं, फ़ील्ड बदलने पर केवल डेटा बदलता है, प्रश्न दोबारा नहीं लिखा जाता (संरचित निर्देशों का उपयोग देखें Noul हाँ-ना प्रश्न)। state भी संरचित पाँच फ़ील्ड है: system_message / instruction / source_text / schema / extraction——जाँचकर्ता को एक्सट्रैक्शन के समय का पूरा संदर्भ दिखता है, उस समय के सिस्टम प्रॉम्प्ट सहित।
💡 यही Jev का अनन्य मूल्य है
जाँचकर्ता एक "जाँची हुई लगने वाली" पाठ-पंक्ति नहीं देता, बल्कि कैलिब्रेटेड P(गड़बड़) देता है——हर फ़ील्ड, हर विफलता मोड के लिए एक संख्या, जिसे क्रमबद्ध किया जा सकता है, थ्रेशोल्ड लगाया जा सकता है, वक्र खींचा जा सकता है। noul संभावनाएँ वास्तविक परिणामों से संरेखित हैं (यह TypeSafe का प्रशिक्षण तरीका है, देखें Jev क्या है), 0.98 और 0.05 के बीच का अंतर ही "इसे मैंने पकड़ लिया" और "इस पर अन्याय न हो" के बीच का अंतर है। साधारण LLM से "जाँच लो" कहें, तो वह एक वाक्य देता है "विवरण थोड़ा गलत लगता है"——कोई संख्या नहीं, कोई फ़ील्ड नाम नहीं, कारण तो बिल्कुल नहीं।
- जाँच-सारणी आधिकारिक संख्याओं से मेल खाती है; मैं बता सकता हूँ कि
descriptionने कौन से तीन हेड ट्रिगर किए औरregistration_open_dateकाabsence_wrongकम क्यों है
चरण 5: तीसरा स्तर——any_flag गेट, मॉडल कैस्केड में अलार्म होने पर ही reasoning मॉडल पर एस्केलेशन
क्यों: जाँच-सारणी नौ संख्याएँ देती है, लेकिन "कब एस्केलेट करें" कोड में एक स्पष्ट रेखा होनी चाहिए। आधिकारिक गेट का नाम any_flag है: कोई भी फ़ील्ड-दर-फ़ील्ड हेड FIRE_T पार करे तो एस्केलेट——max लें, औसत नहीं। औसत लें तो 0.98 का लाल झंडा बाकी हेडों के कम स्कोर से इतना पतला पड़ जाएगा कि अलार्म रेखा के नीचे रह जाएगा, एक आत्मविश्वासी अलार्म "औसत से चुप" करा दिया जाएगा।
एक थ्रेशोल्ड तभी काम कर सकता है जब चरण 4 जैसा पृथक्करण हो: गलत फ़ील्ड का स्कोर ऊँचा, सही फ़ील्ड का कम। यह हिसाब भी इसी चरण में होता है——आधिकारिक रूप से साफ कहा गया है जाँचकर्ता reasoning rung से कहीं ज़्यादा सस्ता होना चाहिए, वरना कैस्केड एक पैसा नहीं बचाएगा: हर रिकॉर्ड पर "mini + जाँच" का खर्च उठेगा, केवल अलार्म वाले रिकॉर्ड पर reasoning का पैसा लगेगा, तभी यह संरचना किफ़ायती है।
# any_flag is a per-field gate: the holistic __overall__ head is shown above but not part of it
fired = {
    qid: p
    for qid, p in checks.items()
    if not qid.startswith("__overall__") and p > FIRE_T
}
escalate = bool(fired)

print(
    f"any_flag gate (threshold {FIRE_T}): {'ESCALATE' if escalate else 'ACCEPT cheap result'}"
)
for qid, p in sorted(fired.items(), key=lambda c: -c[1]):
    print(f"  fired: {qid}  (P={p:.2f})")
python sde_cascade.py चलाएँ। गेट शुद्ध कोड है, कोई अनुरोध नहीं भेजता।
आपको यह दिखना चाहिए (आधिकारिक रिकॉर्डिंग):
any_flag gate (threshold 0.7): ESCALATE
  fired: description::hallucinated  (P=0.98)
  fired: description::off_target  (P=0.97)
  fired: description::unreasonable  (P=0.86)
तीनों fired सीधे description की ओर इशारा करते हैं; __overall__::judge वाला 0.90 स्पष्ट रूप से बाहर रखा गया है——वह केवल तुलना के लिए है, गेट में दाखिल नहीं होता। अलार्म होने पर ही reasoning का पैसा लगता है: gpt-5.5 के साथ reasoning_effort="high" से केवल इसी रिकॉर्ड को दोबारा निकाला जाता है; अलार्म न होने वाले रिकॉर्ड सीधे mini का परिणाम उपयोग करते हैं।
final_record = (
    extract(REASONING, prompt, schema, content, reasoning_effort="high")
    if escalate
    else mini_record
)

print("mini      :", json.dumps(mini_record))
print("reasoning :", json.dumps(final_record))
print("\nfield-level diff (mini -> final):")
for name in mini_record:
    if mini_record[name] != final_record.get(name):
        print(f"  {name}: {mini_record[name]!r}  ->  {final_record.get(name)!r}")
चलाएँ। OPENAI_API_KEY सेट होने पर एक reasoning अनुरोध सच में भेजा जाएगा, उत्तर json_cache.json में जाएँगे।
आपको यह दिखना चाहिए (आधिकारिक रिकॉर्डिंग):
mini      : {"registration_open_date": "", "description": "Registration opens for the fall semester"}
reasoning : {"registration_open_date": "", "description": ""}

field-level diff (mini -> final):
  description: 'Registration opens for the fall semester'  ->  ''
diff में केवल एक पंक्ति है: reasoning मॉडल ने बनाए हुए description को हटा दिया, खाली स्ट्रिंग से बदला——उसने देखा कि पेज ने कभी पंजीकरण तिथि का वर्णन नहीं किया, और आविष्कार करने से इनकार किया। registration_open_date दोनों ओर खाली स्ट्रिंग है, अछूता। कैस्केड ने इस रिकॉर्ड पर reasoning का पैसा लगाया, और वह भी इसलिए क्योंकि जाँच ने नाम लिया था।
- गेट
ESCALATEप्रिंट करता है, तीनों fired आधिकारिक परिणाम से मेल खाते हैं; diff मेंdescriptionखाली स्ट्रिंग हो जाता है; मैं बता सकता हूँ कि max क्यों लें औसत क्यों नहीं, और__overall__::judgeगेट में क्यों नहीं आता
चरण 6: आधिकारिक 100 रिकॉर्ड का लागत/गुणवत्ता वक्र समझना
क्यों: FIRE_T = 0.7 अंदाज़ा लगाकर नहीं बनाया गया। आधिकारिक टीम ने वही लूप (extract → verify → escalate, gpt-5.4-mini → gpt-5.5-reasoning, हर फ़ील्ड-स्तरीय हेड पर any_flag गेटिंग) 100 ScrapeGraphAI-100k एक्स्ट्रैक्शन टास्क पर पूरा चलाया: TypeSafe हर रिकॉर्ड के सस्ते rung एक्स्ट्रैक्शन को सत्यापन स्कोर देता है, गेटिंग थ्रेशोल्ड 0 से 1 तक स्कैन होता है, और हर थ्रेशोल्ड को एक (लागत, गुणवत्ता) बिंदु के रूप में प्लॉट किया जाता है।
स्रोत पर ध्यान दें: यह आधिकारिक आंतरिक टेस्ट परिणाम है, एक पुराने स्वतंत्र रन से — उस रन में सत्यापन मॉडल jev-1.12 था (इस पेज के उदाहरण jev-1.14.0 का उपयोग करते हैं); गुणवत्ता स्कोर LLM judge द्वारा हर एक्स्ट्रैक्शन को दिया गया स्कोर है (ग्राफ़ पर mean llm_judge)।
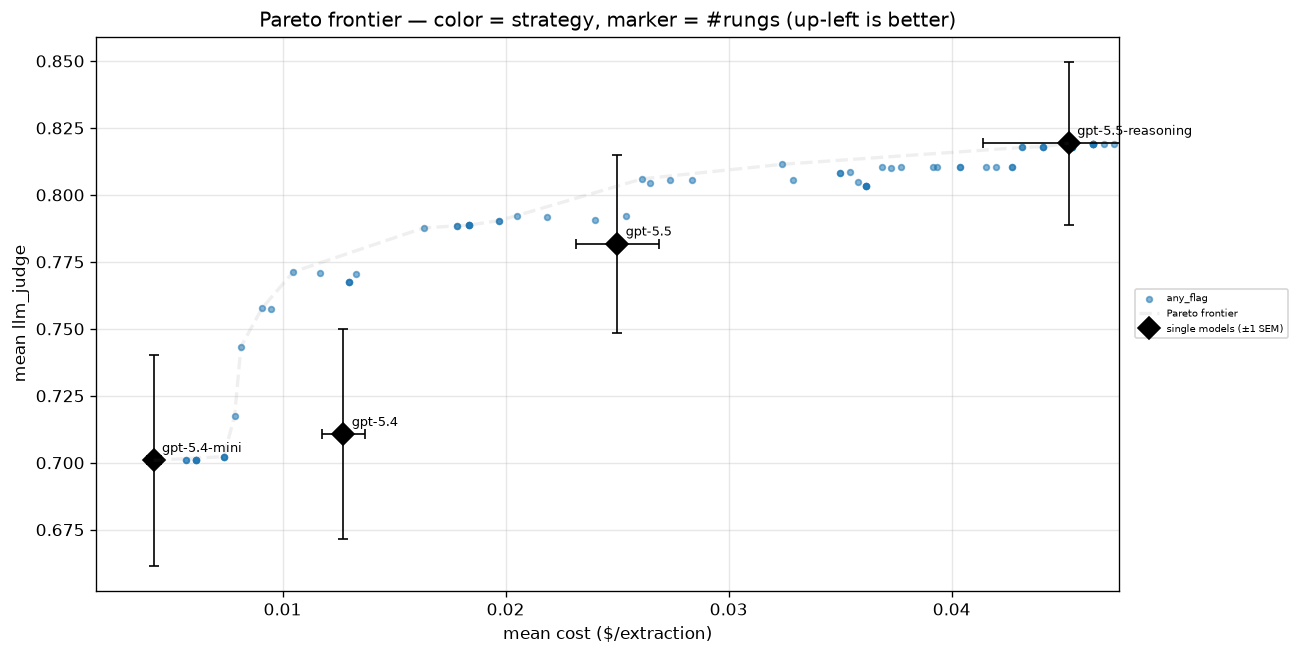
पढ़ने के चार नियम:
| ग्राफ़ का तत्व | यह क्या है | कैसे पढ़ें |
|---|---|---|
| काला हीरा | चारों मॉडल अलग-अलग चलाए गए | क्षमता बढ़ने के साथ लागत बढ़ती है; सबसे मज़बूत gpt-5.5-reasoning दाएँ ऊपर कोने में — सबसे महँगा, सबसे बेहतर |
नीले बिंदु (any_flag) | कैस्केड के कई अलग-अलग गेटिंग थ्रेशोल्ड वाले कॉन्फ़िगरेशन | थ्रेशोल्ड जितना कम, उतनी ज़्यादा रिकॉर्ड अपग्रेड होती हैं, जितना ऊँचा उतनी कम; एक थ्रेशोल्ड, एक बिंदु |
| डैश वाली रेखा | pareto फ्रंटियर | एक ही लागत पर सबसे ऊँची गुणवत्ता वाले कैस्केड कॉन्फ़िगरेशन को जोड़ने वाली रेखा |
| फ्रंटियर की स्थिति | हर एकल मॉडल के बाएँ ऊपर | कैस्केड बिंदु लगभग $0.02/रिकॉर्ड पर लगभग 0.79 देता है; gpt-5.5-reasoning अकेला रन लगभग 0.82 के लिए लगभग $0.045 लेता है |
एक वाक्य में: कैस्केड फ्रंटियर हर एकल मॉडल के बाएँ ऊपर दबा हुआ है — सस्ता rung आसान रिकॉर्ड पूरी कर देता है, केवल फ़्लैग हुई रिकॉर्ड ही रीज़निंग का पैसा देती हैं, इसलिए एक ही लागत पर गुणवत्ता ज़्यादा और एक ही गुणवत्ता पर लागत कम।0.7 कोई जादुई संख्या नहीं है, यह केवल 0→1 स्कैन रेखा पर एक बिंदु है; आपके अपने टास्क का सही बिंदु क्या होगा, यह अपने डेटा पर स्कैन करके ही तय करना होगा (जादुई Prompt में स्कैन का तरीक़ा है)।
- मैं आधिकारिक ग्राफ़ पर pareto फ्रंटियर दिखा सकता/सकती हूँ, बता सकता/सकती हूँ कि «बाएँ ऊपर» का क्या मतलब है, और 0.79 / $0.02 तथा 0.82 / $0.045 दोनों संख्या-जोड़े किस बिंदु से मेल खाते हैं
📋 जादुई Prompt
इस पेज का «Prompt» API के लिए प्रश्न और कोड टेम्पलेट है — कॉपी करें, 【】 प्लेसहोल्डर बदलें (? वाले वैकल्पिक हैं) और अपने एक्स्ट्रैक्शन टास्क से जोड़ सकते हैं। तीन हिस्से: फ़ील्ड-स्तरीय सत्यापन प्रश्न-सेट, any_flag गेटिंग, थ्रेशोल्ड स्कैन।
📝 फ़ील्ड-स्तरीय सत्यापन प्रश्न-सेट (Noul संस्करण)
अपेक्षित प्रभाव: कोई भी टास्क जहाँ «सस्ता मॉडल JSON रिकॉर्ड बनाता है और फ़ील्ड-दर-फ़ील्ड जाँच चाहिए» — प्रोडक्ट पैरामीटर, नौकरी की जानकारी, प्रॉपर्टी लिस्टिंग — वही प्रश्न-सेट, schema बदलकर काम करता है, फ़्लैग फ़ील्ड का नाम + कारण बताता है।
# 必填项:【schema】你的 JSON Schema(字段 description 写清格式与示例);【记录】便宜模型的输出
#         失败模式头逐字抄官方七连:name_desc_mismatch / type_mismatch / unreasonable /
#         hallucinated / off_target / incomplete / format_violation
MAIN_QUESTIONS = {
    "hallucinated": (
        "Is the `extracted_field` unsupported by, or absent from, the source text?",
        NoulCriteria(
            true="the `extracted_field` is a hallucination -- not supported by, or absent "
            "from, the source text",
            false="the `extracted_field` is supported by the source text",
        ),
    ),
    【其余失败模式】: (
        【同一句式:这个字段是不是犯了这种错?】,
        NoulCriteria(true=【犯了这种错的描述】, false=【没犯的描述】),
    ),
}
ABSENCE_QUESTION = (
    "The `extracted_field` is empty, null, or an empty collection. Does the source text "
    "contain the information the `field_spec` describes, making the empty result wrong?"
)
# 选填项:按业务加头——单位、币种、语言、时效;某头总误报先改措辞再调线?
# 输出规范:qid 取 f"{字段名}::{失败模式}";true 一律 = 出问题,noul 就是 P(出问题)
# 约束条件:
# ✅ 循环 schema["properties"] 而不是记录——提取器漏掉的字段照样被问到
# ✅ 空字段只问 absence_wrong;type 未知跳过 type_mismatch
# ❌ 不要拿一道「这条提取对吗」的大题代替题组——大题说不出哪个字段、哪种错
✅ any_flag गेटिंग (कोड संस्करण)
अपेक्षित प्रभाव: अलर्ट लॉजिक एक लाइन का शुद्ध कोड है — कोई भी फ़ील्ड-स्तरीय हेड थ्रेशोल्ड पार करे तो महँगे मॉडल पर अपग्रेड, बिना अलर्ट वाली रिकॉर्ड सीधे सस्ते परिणाम से गुज़रती हैं।
# 必填项:【FIRE_T】报警线(官方示例 0.7;上线前用自己的数据扫一遍再定)
fired = {
    qid: p
    for qid, p in checks.items()
    if not qid.startswith("__overall__") and p > 【FIRE_T】
}
escalate = bool(fired)
final_record = (
    extract(【贵模型】, prompt, schema, content, reasoning_effort="high")
    if escalate
    else mini_record
)
# 选填项:逐头设线——官方明说每道题可单独调阈值,编造类从严、格式类从松?
# 输出规范:fired 字典就是审计日志——哪个字段、哪种病因、多大概率
# 约束条件:
# ✅ 取 max 不取平均——一个自信的红旗不能被低分稀释成沉默
# ✅ 解析失败的记录当空记录进核查——每个字段读作缺失,报警升级,方向安全
# ❌ 别把 __overall__::judge 门进门控——它只作对照,决定升级的是逐字段头
🔧 थ्रेशोल्ड स्कैन (कार्य-बिंदु चुनने का संस्करण)
अपेक्षित प्रभाव: 0.7 अंदाज़े से मत चलाइए — टास्कों का एक बैच लेकर थ्रेशोल्ड 0 से 1 तक स्कैन करें, हर थ्रेशोल्ड के लिए एक (लागत, गुणवत्ता) बिंदु दर्ज करें, अपना फ्रंटियर बनाएँ और फिर कार्य-बिंदु तय करें।
# 必填项:【任务集】一批提取任务(官方用 100 条 ScrapeGraphAI-100k);【打分】质量分怎么算
for fire_t in [i / 10 for i in range(11)]:        # 0.0 -> 1.0
    total_cost = total_quality = 0.0
    for item in 【任务集】:
        record = extract(【便宜模型】, item.prompt, item.schema, item.content)
        checks = verify(record)                    # 每条一次核查
        fired = any(
            p > fire_t for qid, p in checks.items()
            if not qid.startswith("__overall__")
        )
        final = extract(【贵模型】, item.prompt, item.schema, item.content,
                        reasoning_effort="high") if fired else record
        total_cost += 【便宜模型单价 + 核查单价 +(fired 时的贵模型单价)】
        total_quality += 【质量分:官方用 LLM judge 给每条提取打分】
    point = (total_cost / len(【任务集】), total_quality / len(【任务集】))
# 选填项:质量分用人工抽检代替 LLM judge,先抽 20 条看头的分离度?
# 输出规范:一张(成本, 质量)散点图;工作点钉在你预算线与前沿的交点
# 约束条件:
# ✅ 扫描和上线锁同一个核查版本 ID——别用会漂移的 jev-latest
# ✅ 先确认头的分离度(错字段高、对字段低),分离不开什么阈值都白搭
# ❌ 别把官方 0.79 / $0.02 当你的预期——那是 ScrapeGraphAI-100k + jev-1.12 那一轮的数字
चेकपॉइंट ✅
- चरण 5 की गेटिंग प्रिंट
ESCALATE, तीन fired रिकॉर्ड आधिकारिक रिकॉर्डिंग से मेल खाती हैं; रीज़निंग के दोबारा एक्स्ट्रैक्शन मेंdescriptionको खाली स्ट्रिंग से बदला जाता है, diff सिर्फ़ एक लाइन है - मैं इस तीन-स्तरीय मॉडल कैस्केड का काम-बँटवारा बता सकता/सकती हूँ: mini एक्स्ट्रैक्शन, Jev सत्यापन (एक रिक्वेस्ट), अलर्ट होने पर ही
gpt-5.5रीज़निंग का पैसा - मैं जानता/जानती हूँ कि गेटिंग max क्यों लेती है, औसत क्यों नहीं, और
__overall__::judgeकेवल तुलना के लिए क्यों है, गेटिंग में क्यों नहीं - मैं समझा सकता/सकती हूँ कि «पार्सिंग विफल होने पर
{}लौटाना» सुरक्षित दिशा क्यों है: हर फ़ील्ड अनुपस्थित पढ़ा जाता है → सत्यापन अलर्ट → गेटिंग अपग्रेड करती है - मैं आधिकारिक 100 रिकॉर्ड वाले ग्राफ़ पर pareto फ्रंटियर दिखा सकता/सकती हूँ, बता सकता/सकती हूँ कि 0.79 / $0.02 तथा 0.82 / $0.045 कौन-से बिंदु हैं, और 0.7 सिर्फ़ स्कैन रेखा पर एक बिंदु है
सावधानियाँ
❌ गेटिंग औसत ले, लाल फ़्लैग पतले पड़ जाते हैं
any_flag एक max-प्रकार की गेटिंग है, आधिकारिक टीम ने खास ज़ोर देकर कहा «औसत नहीं»: एक आत्मविश्वासी लाल फ़्लैग अपग्रेड के लिए काफ़ी है, न कि कम स्कोर वाले हेड्स की कतार में औसत पड़ जाना। इस पेज के उदाहरण में description::hallucinated 0.98 तक पहुँचता है, सबसे कम हेड सिर्फ़ 0.04 — औसत लें तो यह मनगढ़ंत रिकॉर्ड थ्रेशोल्ड से नीचे रहकर भी डेटाबेस में घुस जाती है; max लें तो वही तुरंत पकड़ी जाती है। जब फ़्लैग का अलगाव अच्छा हो (ग़लत फ़ील्ड ऊँचा, सही फ़ील्ड नीचा), max सबसे संवेदनशील गेट है।
❌ __overall__::judge को भी गेटिंग में गिनना
गेटिंग कोड में not qid.startswith("__overall__") स्पष्ट रूप से बाहर रखा गया है। आधिकारिक टीम ने यह बड़ा प्रश्न इसलिए रखा ताकि «पूरी रिकॉर्ड पर एक प्रश्न» और «फ़ील्ड-स्तरीय प्रश्न-सेट» का अंतर दिखे: यह 0.90 रिपोर्ट करता है, लेकिन यह नहीं बता सकता कि कौन-सी फ़ील्ड ग़लत है, क्यों ग़लत है। अपग्रेड का फ़ैसला हमेशा फ़ील्ड-स्तरीय हेड से होता है — फ़्लैग की क़ीमत «फ़ील्ड + कारण» में है, तो गेटिंग भी स्वाभाविक रूप से फ़्लैग पर ही लगती है।
❌ एक्स्ट्रैक्शन के लिए स्ट्रक्चर्ड आउटपुट / JSON mode चालू करना «ग़लती से बचाने» के लिए
दोनों rung शुद्ध टेक्स्ट रिप्लाई देते हैं, आधिकारिक टीम का तर्क उलटा लगता है: इस कैस्केड को पकड़नी हैं वे ग़लतियाँ जो schema-वैध हैं। कंस्ट्रेंड डिकोडिंग आकार सही रखता है, पर «पेज ग़लत पढ़ने से schema टूटने वाले» मॉडल को छिपा देता है, सत्यापन के पास कुछ हाथ नहीं लगता; आकार से जुड़ी ग़लतियाँ jsonschema एक लाइन में रोकी जा सकती हैं। सिमेंटिक सत्यापन का काम डिकोडर को दे देना मतलब है सबसे धोखेबाज़ ग़लती छोड़ना और सबसे साफ़ ग़लती रोकना।
❌ सत्यापक रीज़निंग मॉडल से सस्ता न हो, कैस्केड बेकार
आधिकारिक टीम ने साफ़ कह दिया: सत्यापक रीज़निंग rung से कहीं ज़्यादा सस्ता होना चाहिए, वरना कैस्केड एक पैसी भी नहीं बचाता। इस संरचना का हिसाब है: हर रिकॉर्ड पर «सस्ता एक्स्ट्रैक्शन + एक सत्यापन», केवल अलर्ट वाली रिकॉर्ड रीज़निंग का पैसा देती हैं। अगर सत्यापक रीज़निंग जितना महँगा हो, तो आप हर रिकॉर्ड पर रीज़निंग क़ीमत दे रहे हैं, और अलर्ट वाली रिकॉर्ड पर ऊपर से एक और। आधिकारिक 100 रिकॉर्ड की कर्व पर कैस्केड लगभग $0.02/रिकॉर्ड तक दब पाता है, इसीलिए कि सत्यापन बहुत सस्ता है + ज़्यादातर रिकॉर्ड अलर्ट नहीं करतीं।
एडवांस टिप्स (वैकल्पिक)
फ़ेलियर-मोड हेड पर जोड़-घटाव करें। आधिकारिक टीम ने साफ़ कहा कि हर प्रश्न का शब्द-चयन अलग से बदला जा सकता है, थ्रेशोल्ड अलग से ट्यून किया जा सकता है — प्रश्न-सेट बस एक डिक्शनरी है, एक हेड जोड़ना एक लाइन जोड़ना है। आधिकारिक सात-प्रश्न सेट सामान्य फ़ेलियर मोड है; आपके डोमेन के ख़ास दोष हैं (यूनिट, करेंसी, भाषा, समय-सीमा) तो अलग हेड जोड़ें। प्रश्न छेड़ने से पहले अगली बात याद रखें: प्रश्न बदलने से कैश ख़राब नहीं होता।
प्रश्न बदलने से कैश ख़राब नहीं होता, फ़ाइल मिटाने पर ही असली रन होता है। JsonCache की कुंजी सिर्फ़ फ़ंक्शन का नाम और आर्ग्युमेंट हैं — cooksafe दस्तावेज़ के शब्द: फ़ंक्शन बॉडी बदलने से मौजूदा एंट्री ख़राब नहीं होती। verify का प्रश्न-सेट फ़ंक्शन बॉडी में बनता है, MAIN_QUESTIONS का शब्द-चयन बदलने या हेड जोड़ने पर कैश कुंजी नहीं बदलती, पुराने उत्तर पहले की तरह चलते हैं; नए प्रश्न से असली रिक्वेस्ट चाहिए तो पहले json_cache.json मिटाएँ। FIRE_T ट्यून करने पर कोई फ़र्क़ नहीं पड़ता — गेटिंग शुद्ध कोड है, कैश से नहीं गुज़रती।
आधिकारिक सत्यापन प्रश्न-सेट मुफ़्त में आज़माएँ। आधिकारिक SDE cascade cookbook सत्यापन आउटपुट के नीचे बना हुआ Playground शेयर लिंक देता है — चरण 4 वाला प्रश्न-सेट example.json के पूरे state के साथ, खोलते ही ब्राउज़र में शब्द बदल सकते हैं, प्रायिकता वितरण देख सकते हैं। अपनी रिकॉर्ड के लिए लिंक बनाना हो तो चरण 4 के कोड में make_playground_link(state, questions) पहले से तैयार है — लिंक में पूरा state और प्रश्न शामिल होते हैं, जिसे लिंक मिले वह पढ़ सकता है, संवेदनशील डेटा मत डालें।
अपनी अपनी बैच पाइपलाइन से जोड़ें। तीनों हिस्से एक ही पैटर्न के हैं — "schema + content अंदर, रिकॉर्ड + फ्लैग बाहर": schema की जगह अपनी फ़ील्ड टेबल, content की जगह आपके स्क्रैप किए पेज, और extract / verify / गेटिंग जस-के-तस दोबारा इस्तेमाल करें। चलाने के बाद जल्दी में थ्रेशोल्ड मत तय करें — डेटा का एक बैच जमा करके 6वें स्टेप के स्कैन तरीके से अपनी कर्व बनाएं, और अपने बजट लाइन पर वर्किंग पॉइंट पिन करें।
इस पाठ का सारांश
✅ तीन-स्तरीय मॉडल कैस्केड = सस्ता एक्सट्रैक्शन + Jev पूरी जांच + महंगे मॉडल का बैकअप: gpt-5.4-mini प्योर-टेक्स्ट एक्सट्रैक्शन (जानबूझकर स्ट्रक्चर्ड आउटपुट ऑफ रखा)→ Jev एक ही रिक्वेस्ट में फ़ील्ड-दर-फ़ील्ड जांच → any_flag अलर्ट होने पर ही एस्केलेशन gpt-5.5 (reasoning_effort="high")।
✅ फ्लैग फ़ील्ड का नाम + कारण बताते हैं: ऑफिशियल उदाहरण में मनगढ़ंत description तीन अलर्ट देता है (0.98 / 0.97 / 0.86), जबकि सही खाली फ़ील्ड absence_wrong पर सिर्फ 0.05; रीज़निंग मॉडल मनगढ़ंत वैल्यू हटा देता है, और कैस्केड सिर्फ नाम लिए गए एंट्री के लिए रीज़निंग का पैसा देता है।
✅ गेटिंग max लेता है, औसत नहीं, __overall__ सिर्फ तुलना के लिए: कोई भी फ़ील्ड-दर-फ़ील्ड स्कोर FIRE_T से ऊपर हो तो एस्केलेट; पार्स फेल होने पर {} लौटाना सुरक्षित दिशा है; यह हिसाब तभी खरा उतरता है जब जांचकर्ता रीज़निंग rung से कहीं सस्ता हो।
✅ ऑफिशियल 100 कर्वें वर्किंग पॉइंट तय करती हैं: कैस्केड की फ्रंटियर हर सिंगल मॉडल के ऊपर-बाएं है — करीब $0.02/एंट्री पर करीब 0.79 मिलता है, जबकि gpt-5.5-reasoning सिंगल रन में 0.82 के लिए करीब $0.045 चाहिए; 0.7 स्कैन लाइन का सिर्फ एक पॉइंट है, अपने टास्क का स्कैन खुद करें।
मुख्य कॉन्फ़िगरेशन फ़ील्ड की समीक्षा:
| फ़ील्ड | इस पेज की वैल्यू | विवरण |
|---|---|---|
MINI / REASONING | gpt-5.4-mini / gpt-5.5 (reasoning_effort="high") | दो एक्सट्रैक्शन rung, प्योर-टेक्स्ट रिप्लाई; मॉडल बदलने के लिए सिर्फ ये दो लाइनें बदलें |
TS_MODEL | jev-1.14.0 | जांच मॉडल; ऑफिशियल 100 एंट्री वाले राउंड में jev-1.12 था; लाइव रन में वर्ज़न ID लॉक करें, jev-latest मत इस्तेमाल करें |
FIRE_T | 0.7 | any_flag अलर्ट लाइन; ऑफिशियल ने 0→1 पूरा स्कैन करके वर्किंग पॉइंट चुना |
| फेलियर-मोड स्कोर | 7 प्रकार + absence_wrong (अलग से __overall__::judge तुलना के लिए) | गैर-खाली फ़ील्ड पर पूरा सेट, खाली फ़ील्ड पर सिर्फ absence_wrong, type अज्ञात होने पर स्किप type_mismatch |
| कैश | json_cache.json | LLM + TypeSafe कॉल सब कैश में जाते हैं; प्रॉम्प्ट बदलने पर खराब नहीं होता, फ़ाइल मिटाने पर ही असली रिक्वेस्ट जाती है |
| प्रति एंट्री रिक्वेस्ट | mini 1 बार + जांच 1 बार (प्रश्न-सेट समानांतर) + अलर्ट होने पर ही रीज़निंग 1 बार | ज़्यादातर एंट्री सिर्फ पहले दो स्तरों का पैसा देती हैं |
संबंधित ट्यूटोरियल:
- वैल्यू एक्सट्रैक्शन: तारीख, ईमेल, फ़ोन, रकम अक्षरशः सही निकालना — सिंगल-फ़ील्ड बारीकी से चुनने वाला वर्ज़न: Jev खुद वैल्यू सही चुनता है; बड़े वॉल्यूम पर जाकर इस पेज के कैस्केड डिविज़न की ज़रूरत पड़ती है
- समानांतर प्रश्न और स्पेक्युलेटिव फैन-आउट — "हर फ़ील्ड हर फेलियर-मोड के लिए एक प्रश्न, एक ही रिक्वेस्ट में सब पूछना" — इसका अंतर्निहित तंत्र
- Noul हां-ना प्रश्न — जांच प्रश्नों का फॉर्मैट: स्ट्रक्चर्ड instructions, true = समस्या मिली, noul = P(true)
अगले पाठ की झलक
टेक्स्ट वाली यह चेन जांच ली गई, लेकिन स्कैन किए दस्तावेज़ और OCR के पढ़े वैल्यू की जांच कैसे हो? अगला पाठ: इमेज इन प्रैक्टिस: स्कैन दस्तावेज़ पढ़ना, OCR नतीजे क्रॉस-चेक करना।
आप सीखेंगे:
- स्कैन दस्तावेज़ पढ़ने की पाइपलाइन: Noul पता करता है कि मौजूद है या नहीं, Box पता करता है कि कहाँ है, Choice वैल्यू पढ़ता है — स्टिकर से ढकी तारीख मिलती है
unreadable, न कि अंदाज़े का साल - OCR एक्सट्रैक्टेड वैल्यू की जांच: हर फ़ील्ड पूरे पेज पर एक बार, क्रॉप की गई इमेज पर फिर बारीकी से एक बार; 0.25 से नीचे होने पर मानव-समीक्षा को भेजें, और मूल इमेज पर रीव्यू बॉक्स बनाएं
- इस पेज जैसा ही "कैलिब्रेटेड प्रॉबेबिलिटी + कोड में थ्रेशोल्ड" वाला जांच-फिल्टर विचार — बस जांच का लक्ष्य टेक्स्ट एक्सट्रैक्शन से बदलकर इमेज से पढ़े वैल्यू हैं