الاستخراج بسلسلة: النموذج الرخيص يقوم بالعمل، تحقق عبر Jev، والنموذج الباهظ كخط دفاع أخير
💡 الخلاصة في جملة: ابنِ باستخدام Jev خط أنابيب سلسلة نماذج — النموذج الرخيص يستخرج أولًا، ثم تحقق Jev حقلًا بحقل (Noul واحد لكل حقل لكل نمط فشل)، ولا يُرقّى إلى نموذج الاستدلال إلا عند إنذار any_flag، فتُنفق التكلفة فقط على السجلات القليلة المُسمّاة.
مهمات «الاستخراج المهيكل» — تحويل صفحات الويب والمستندات إلى سجلات JSON — لها بنية تكلفة محرجة: نماذج الاستدلال الكبيرة تستخرج جيدًا لكنها بطيئة وباهظة، والنماذج الصغيرة رخيصة لكنها ترتكب أخطر أنواع الأخطاء خفاءً. كتاب الوصفات الرسمي SDE cascade يقولها بصراحة: النماذج الرخيصة ترتكب أخطاء، ونماذج الاستدلال الباهظة تستخرج جيدًا لكنها بطيئة وباهظة. والسلسلة (cascade) هي الحل: النموذج الصغير يقوم بالعمل الخشن أولًا، ويتحقق TypeSafe حقلًا بحقل من مخرجاته، ولا يُرقّى إلى النموذج الكبير إلا عند إنذار التحقق.
هذا الدرس هو «النسخة الصناعية» التي وُعد بها في نهاية درس استخراج القيم. عند استخراج حقل واحد يستطيع Jev بنفسه اختيار القيمة الصحيحة؛ لكن عندما تكون مهمتك تحويل عشرات الآلاف من صفحات الويب يوميًا إلى JSON، فإن جعل Jev يستخرج حقلًا بحقل بنفسه ترفٌ باهظ، وجعل النموذج الرخيص يتولى كل شيء وحده لا يُطمئن للإطلاق — وجواب هذا الدرس هو تقسيم العمل ثلاثًا: نموذج رخيص للاستخراج، تحقق عبر Jev، ونموذج باهظ كخط دفاع أخير. اختبر المسؤولون هذه الدورة على 100 مهمة استخراج حقيقية: تقع منحنيات السلسلة فوق يسار كل نموذج منفرد — بنحو $0.02 للسجل تحقق نقاط السلسلة جودة حوالي 0.79، بينما أقوى نموذج gpt-5.5-reasoning منفردًا بجودة 0.82 يكلف حوالي $0.045. مدة هذا الدرس حوالي 20 دقيقة، ومستوى متقدم.
ماذا ستستطيع أن تفعل بعد إتمام الدرس
- بناء سلسلة نماذج ثلاثية المستويات: استخراج عبر
gpt-5.4-mini→ تحقق حقلًا بحقل عبر Jev في طلب واحد → لا ترقية إلى استدلالgpt-5.5إلا عند إنذارany_flag— معظم السجلات تدفع ثمن النموذج الرخيص فقط - جعل كل سجل يحمل أعلامًا حقلًا بحقل: أي حقل مريب وفي ماذا ريبه (تلفيق / إزاحة / إغفال / مخالفة تنسيق)، بدلًا من درجة إجمالية غامضة واحدة
- اصطياد التلفيق «المتوافق مع الـ schema لكنه خاطئ دلاليًا» — النوع الذي لا يوقفه حتى نجاح تحقق JSON Schema بالكامل
- اختيار نقطة عملك الخاصة بمنهج المسؤولين نفسه: امسح عتبة الإنذار من 0 إلى 1، وارسم منحنى التكلفة / الجودة، بدلًا من اعتماد 0.7 اعتباطًا والانتهاء عند ذلك
لماذا نستخدم Jev للتحقق بدلًا من ترك كل شيء للنموذج الباهظ؟
| القدرة | النموذج الباهظ يتولى كل شيء | نموذج رخيص + سلسلة Jev |
|---|---|---|
| التكلفة | ❌ دفع ثمن الاستدلال لكل سجل: منحنى المسؤولين gpt-5.5-reasoning حوالي $0.045/سجل | ✅ معظم السجلات تدفع ثمن mini فقط مع تحقق Jev واحد: منحنى المسؤولين حوالي $0.02/سجل |
| الجودة | ✅ الأفضل بين النماذج المنفردة (0.82) | ✅ حوالي 0.79، بفارق 0.03 فقط، مع توفير أكثر من نصف التكلفة |
| رؤية الأخطاء | ❌ دفعة واحدة، عند الخطأ لا يُعرف أي حقل وأي نوع من الخطأ | ✅ Noul واحد لكل نمط فشل، والأعلام تسمّي الحقل + السبب |
| الأخطاء المُتقَنة التلفيق | ❌ JSON Schema يتحقق من الشكل فقط ولا يكشف التلفيق الدلالي | ✅ التحقق الدلالي يصطاد خصيصًا قيم الهلوسة المتوافقة مع الـ schema |
| السرعة | ❌ انتظار الاستدلال العميق لكل سجل | ✅ السجلات بلا إنذار لا تدخل مستوى الاستدلال |
باختصار: النموذج الباهظ هو «تأمين شامل على كل شيء»، وسلسلة النماذج هي «نموذج رخيص يقوم بالعمل + مفتش جودة رخيص يفحص كل شيء + إعادة تصنيع المعيب فقط» — يجب أن يكون المفتش أرخص بكثير من الحرفي الخبير حتى تصمد هذه المعادلة (تُحسب هذه الحسبة في الخطوة 5).
مأزقك الحالي
- «عشرات الآلاف من صفحات الويب يوميًا يجب تحويلها إلى سجلات مهيكلة، تشغيل نماذج الاستدلال على الكل يرهق الفاتورة؛ والاعتماد الكامل على النماذج الرخيصة لا يدعك تعرف أي سجل منها ملفّق»
- «أخطاء النموذج الرخيص متوافقة مع الـ schema بالضبط: تحقق JSON Schema ناجح بالكامل، والأوصاف الملفّقة تدخل قاعدة البيانات رغم ذلك، وعند وقوع مشكلة لا يمكن أثناء التتبع الرجعي حتى معرفة أي خطوة أخطأت»
- «أريد إضافة فحص بشري بالعيّنة، لكنني لا أعرف أي السجلات أختار — كل سجل يبدو سليمًا تمامًا»
متى تستخدم هذه الحيلة
عندما تحتاج إلى:
- استخراج مهيكل بكميات كبيرة: صفحات الويب، مستندات → سجلات JSON، بكميات تجعل التكلفة عاملًا حساسًا
- شكل أخطاء النماذج الرخيصة هو «الاختلاق المُقنع» وليس «التنسيق السيئ» (أخطاء التنسيق يمكنك التحقق منها بنفسك)
- يحمل كل سجل رايةً تشير إلى «أي حقل مريب ولماذا هو مريب»، فيكون لإعادة العمل والتدقيق العشوائي هدف واضح
وأيضًا لا تريد:
- دفع ثمن نموذج الاستدلال مقابل كل سجلة
- أن تكون نتيجة التحقق نصًا «يبدو أنه تمت مراجعته» بدلًا من أرقام يمكن ضبط عتبة لها وترتيبها
- الانهيار عند فشل التحليل — في السلسلة، أي رد لا يمكن تحليله يُعامل مباشرة كسجلة فارغة ويُمرَّر إلى التحقق لرفع الإنذار والتصعيد، وهذا اتجاه آمن
🎒 الاستعدادات قبل البدء
- أكملت أسئلة نول صح/خطأ: كل سؤال في التحقق هو نول،
noulهو P(true) لـ 0–1، ولا يوجد confidence - نجحت في تشغيلالتثبيت وأول طلب:
.venvمتاح، وستقرأresponse.answers - يُنصح بقراءة استخراج القيم: هذه الصفحة هي «النسخة الصناعية من الخط» الذي وُعد به في نهايتها — كيفية اختيار القيمة المفردة الصحيحة تُشرح هناك؛ وهذه الصفحة تتولى فقط حساب تكلفة «حقول متعددة + نماذج متعددة»
- مفتاحان:
TYPESAFE_API_KEY(التحقق عبر Jev) +OPENAI_API_KEY(في المثال الرسمي، rung 0 / rung 1 هماgpt-5.4-mini/gpt-5.5من OpenAI) - فنجان قهوة ☕ — 20 دقيقة، مستوى متقدم: خط كامل يمر عبر ثلاثة نماذج
اتبع خطواتي
أنشئ sde_cascade.py، والصق كتل الكود لكل خطوة أدناهبالترتيبفي الملف نفسه. لنوضح طريقة التشغيل أولًا: جميع المخرجات في هذه الصفحة هيأرقام مسجلة من cookbook الرسمي، ننقلها كما هي لتقارن بها إجاباتك؛ عند تشغيلك في الوقت الفعلي قد تختلف الأرقام قليلًا، لكن «أي رأس يرفع الإنذار» يجب أن يكون متطابقًا. يخزّن الطرف الرسمي استدعاءات LLM و TypeSafe مؤقتًا في json_cache.json — إعادة التشغيل لا تكرّر الإنفاق، وإذا أردت طلبات حقيقية فاحذف هذا الملف.
الخطوة 1: تثبيت البيئة وضبط المفتاحين — كل مستوى في مكانه
لماذا: تمتد السلسلة عبر ثلاثة مستويات — مستويا الاستخراج rung يستخدمان واجهة OpenAI، والتحقق يتم عبر TypeSafe. نثبّت أولًا كل التبعيات ونثبّت ثلاثة ثوابت للنماذج وخط إنذار واحد، وكل خطوة لاحقة تشير إليها فقط.
ثبّت التبعيات (الأمر الرسمي كما هو؛ cooksafe هي مكتبة الأدوات المرافقة لـ cookbook الرسمي، 0.2.0 تعلن الاعتماد على typesafe-sdk>=0.7.0,<0.8.0، وسيُثبِّت SDK تلقائيًا معها):
pip install openai jsonschema ipython 'cooksafe>=0.2.0,<0.3.0'اضبط المفتاحين في البيئة، ثم الصق في رأس الملف:
import json
import os
import urllib.request
from pathlib import Path

import jsonschema
from cooksafe import JsonCache, make_playground_link
from openai import OpenAI
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

MINI = "gpt-5.4-mini"  # rung 0: cheap + fast
REASONING = "gpt-5.5"  # rung 1: strong, run with reasoning_effort="high"
TS_MODEL = "jev-1.14.0"  # the TypeSafe verifier model
FIRE_T = 0.7  # escalate if any per-field P(wrong) exceeds this

oai = OpenAI()
ts = TypeSafeClient(api_key=os.environ["TYPESAFE_API_KEY"], timeout=30.0)
print("setup ok")
شغّل python sde_cascade.py.
يجب أن ترى: setup ok — هذه الخطوة مجرد تجميع، لم تُرسل أي طلبات بعد.
اقرأ الثوابت الثلاثة، فبذلك يتحدد مخطط التوظيف للسلسلة بأكملها:
| الثابت | قيمة المثال الرسمي | الدور |
|---|---|---|
MINI | gpt-5.4-mini | rung 0: رخيص + سريع، يقوم بالعمل الخشن |
REASONING | gpt-5.5(مع reasoning_effort="high") | rung 1: قوي لكنه مكلف، لا يظهر إلا عند الإنذار |
TS_MODEL | jev-1.14.0 | المدقق: يعطي P(حدوث مشكلة) لكل حقل ولكل نمط فشل |
FIRE_T | 0.7 | خط الإنذار: أي رأس فردي يتجاوزه يُرفَّع للمستوى الأعلى |
المستويان rung هما مجرد ثابتين نصيين — الكود يمررهما كما هوما إلى واجهة chat completions، واستبدالهما بنموذج رخيص / مكلف من اختيارك يتطلب تعديل هذين السطرين فقط. عند استبدال مستوى التحقق بنسخة Jev، ثبّت معرّف الإصدار المحدد (الاسم المستعار jev-latest يتغير مع الإصدارات)، انظر النماذج والأسعار.
setup okتمت طباعته، والمفتاحان كلاهما في متغيرات البيئة
الخطوة 2: تجهيز المواد — مثال «الصفحة لا تحتوي على إجابة»
لماذا: محكّ اختبار المستخرِج ليس ما استخرجه بشكل صحيح، بل كيف يتصرف عندمالا توجد إجابة في الصفحة. أعدّ الطرف الرسمي لهذا الدرس مثالًا مخصصًا «لاختبار رفض الاختراع»، فنزّله أولًا وانظر إليه بوضوح.
EXAMPLE = Path("example.json")
EXAMPLE_URL = (
    "https://raw.githubusercontent.com/typesafe-ai/typesafe-public-examples/main/"
    "cookbooks/sde_cascade/example.json"
)
if not EXAMPLE.exists():
    urllib.request.urlretrieve(EXAMPLE_URL, EXAMPLE)
example = json.loads(EXAMPLE.read_text())
schema = example["schema"]
prompt = example["prompt"]
content = example["content"]
print(prompt, json.dumps(schema, indent=2), content, sep="\n===========\n")
شغّل، وانظر إلى ثلاثة أشياء.
يجب أن ترى(نُقل prompt و schema المثال الرسمي كما هما؛ نص الصفحة طويل، فنلخّصه بالنقاط):
Find the date fall registration opens at Wrenfield Community College in Wrenfield,
Oregon, for the 2026-2027 school year.
===========
{
  "title": "RegistrationOpen",
  "type": "object",
  "properties": {
    "registration_open_date": {
      "title": "Registration Open Date",
      "type": "string",
      "description": "The date registration opens for the fall semester, in mm/dd/yyyy format, such as 08/03/2026. Return a blank string if you are unsure."
    },
    "description": {
      "title": "Description",
      "type": "string",
      "description": "A short description of the registration open date, such as 'Registration opens for the fall semester'."
    }
  },
  "required": ["registration_open_date", "description"]
}
===========
(صفحة تقويم الأنشطة لكلية Wrenfield Community College: تنقّل، صندوق بحث،
النشاط الوحيد هو «Fall 2026 Census Date — Monday, September 14, 2026»،
أي تاريخ التعداد الخاص بموعد الانسحاب من المقررات؛ الصفحة بأكملها لا تحتوي على أي تاريخ لفتح التسجيل، ولا على وصف له)
فخّان مدفونان في المادة، يجب رؤيتهما عند قراءة السؤال:
الصفحة لا تحتوي على إجابة: هذه صفحة تقويم أنشطة لكلية، والحدث الوحيد هو يوم التعداد الخريفي (موعد الانسحاب من المقررات) — وهيلا تحتوي على تاريخ فتح التسجيل ولا على وصف لهذا التاريخ. المستخرِج الملتزم بالقواعد يجب أن يرفض اختراع هذين الحقلين
يحتوي schema على «قيمة مثال» جاهزة: في description حقل
descriptionمكتوب such as 'Registration opens for the fall semester' — نموذج يبحث عن الطريق المختصر سينسخ هذا المثال حرفيًا إلى الإجابة. وهذا بالضبط الفخ الذي سيقع فيه النموذج الرخيص في الخطوة 3أستطيع أن أذكر «نقطة الاختبار» لهذا المثال: الصفحة بلا إجابة + قيمة مثال جاهزة ملقاة في schema
الخطوة 3: المستوى الأول — استخراج بنموذج رخيص، مع تجاهل المخرجات المهيكلة عمدًا
لماذا: يستخدم مستويا rung كلاهماردودًا نصية خالصةفي الاستخراج — دون تفعيل المخرجات المهيكلة، ولا استدعاء الأدوات، ولا وضع JSON. مبرر الطرف الرسمي غير بديهي: الأخطاء التي تريد هذه السلسلة التقاطها هي أخطاء متوافقة مع schema؛ فك الترميز المقيّد سيخفي فقط النماذج التي «تكسر schema بسبب قراءة الصفحة خطأً»، فيترك التحقق بلا ما يتحقق منه. أما أخطاء التنسيق السيئ فيمكنك التحقق منها بنفسك، والأخطاء المُختلقة بشكل مقنع هي التي تحتاج إلى تحقق دلالي.
EXTRACT_SYSTEM = (
    "You extract structured data from documents. Return only values supported by the text. "
    "Follow any value format specified by the schema or its field descriptions."
)

# LLM and TypeSafe calls are cached in json_cache.json, so a re-run reuses earlier answers
# instead of calling the APIs again; delete the file to call them fresh.
json_cache = JsonCache(Path("json_cache.json"))


@json_cache
def extract(
    model: str,
    prompt: str,
    schema: dict,
    content: str,
    *,
    reasoning_effort: str | None = None,
    temperature: float | None = None,
) -> dict:
    user = (
        f"{prompt}\n\nReturn ONLY a JSON object matching this JSON Schema:\n"
        f"{json.dumps(schema, indent=2)}\n\nDocument:\n{content}"
    )
    kwargs = {
        "model": model,
        "messages": [
            {"role": "system", "content": EXTRACT_SYSTEM},
            {"role": "user", "content": user},
        ],
    }
    if reasoning_effort:
        kwargs["reasoning_effort"] = reasoning_effort
    if temperature is not None:
        kwargs["temperature"] = temperature
    text = oai.chat.completions.create(**kwargs).choices[0].message.content
    # The prompt asks for ONLY a JSON object, so parse the reply as-is -- no regex fishing a
    # substring out of a malformed reply. If json.loads fails, treat it as an empty extraction:
    # every field reads as absent, which the verifier flags and the gate escalates -- the safe
    # direction.
    try:
        return json.loads(text)
    except (ValueError, json.JSONDecodeError):
        return {}


mini_record = extract(MINI, prompt, schema, content, temperature=0)
print("mini extraction:\n", json.dumps(mini_record, indent=2))
print("\nschema-valid:", jsonschema.Draft202012Validator(schema).is_valid(mini_record))
شغّل python sde_cascade.py. إذا ضُبط OPENAI_API_KEY فسيُرسل فعليًا طلب mini واحد، وتدخل الإجابة في json_cache.json.
يجب أن ترى (تسجيل رسمي):
mini extraction:
 {
  "registration_open_date": "",
  "description": "Registration opens for the fall semester"
}

schema-valid: True
توقف لحظة — هذا السجل ** قانوني لكنه خاطئ **، نصفه صحيح ونصفه مُختلَق:
registration_open_dateكونه فارغًا هو ** الصواب **: الصفحة فعلًا لا تذكر تاريخ التسجيل، وschema يصرّح بأن تُعاد سلسلة فارغة عند عدم اليقينdescriptionهو ** مُختلَق **: الصفحة لم تصف تاريخ التسجيل أبدًا، وmini نقل حرفيًا الجملة النموذجية من وصف حقل الـ schemajsonschemaتطبع التحققTrue— ** JSON Schema لا يرى هذا النوع من الأخطاء **. ما ينتجه النموذج الرخيص هو بالضبط هذا الاختلاق الواثق الذي يمرّ بكل فحوص schema الخضراء، والإمساك به هو عمل المدقق الدلالي
انظر أيضًا إلى ذلك الاحتياط في except: الرد الذي يفشل تحليله يُعاد مباشرة كـ {} — كل حقل يُقرأ كمفقود، وسيُطلق التحقق إنذارًا، وستُرقّي البوابة. ** اتجاه الفشل آمن **: يُفضَّل دفع تكلفة استدلال إضافية على ترك سجل سيئ يمر.
- مخرجات mini تطابق
schema-valid: True؛ وأستطيع أن أشير إلى سبب كونdescriptionمختلقًا وregistration_open_dateصحيحًا
الخطوة 4: المستوى الثاني — Jev تحقق حقلًا بحقل، Noul واحد لكل وضع فشل
**لماذا **: سؤال واحد كبير «هل هذا الاستخراج صحيح؟» يعطي درجة واحدة فقط، ولا يستطيع أن يقول أي حقل أخطأ ولماذا. النهج الرسمي هو Decompose the questions — ** كل حقل × كل وضع فشل، Noul ضيّق واحد **، بصياغة موحّدة مؤطَّرة كـ «true = حدثت مشكلة»، وnoul هو P(حدوث مشكلة). تحمل الأعلام اسم الحقل والسبب، ويمكن لكل سؤال تعديل صياغته وعتبته على حدة. ويُسأل مجموعة الأسئلة كاملة في استدعاء system_one واحد بالتوازي (لآلية الأسئلة المتعددة في طلب واحد انظر الأسئلة المتوازية والتوسع التخميني).
# metric -> (question, NoulCriteria)
MAIN_QUESTIONS = {
    "name_desc_mismatch": (
        "Does the `extracted_field` fail to match the field at `path` or the `description` in the "
        "`field_spec`? If the `description` is empty, judge against the `path` alone.",
        NoulCriteria(
            true="the `extracted_field` does not match the field name or its `description`",
            false="the `extracted_field` matches the field name and `description`",
        ),
    ),
    "type_mismatch": (
        "Does the `extracted_field` violate the `type` declared in the `field_spec`?",
        NoulCriteria(
            true="the `extracted_field` violates the declared `type`",
            false="the `extracted_field` conforms to the declared `type`",
        ),
    ),
    "unreasonable": (
        "Is the `extracted_field` one that a reasonable person would not have extracted for this "
        "`field_spec`?",
        NoulCriteria(
            true="a reasonable person would not have extracted this value",
            false="the extraction is reasonable",
        ),
    ),
    "hallucinated": (
        "Is the `extracted_field` unsupported by, or absent from, the source text?",
        NoulCriteria(
            true="the `extracted_field` is a hallucination -- not supported by, or absent "
            "from, the source text",
            false="the `extracted_field` is supported by the source text",
        ),
    ),
    "off_target": (
        "Does the source text fail to genuinely report the thing the `field_spec` describes, so the "
        "value was pulled from incidental text?",
        NoulCriteria(
            true="the source does not genuinely provide this field -- the value was pulled "
            "from incidental text",
            false="the source genuinely reports this field",
        ),
    ),
    "incomplete": (
        "Does the `extracted_field` fail to capture a value the source supports (note whether the "
        "`field_spec` is `required`)?",
        NoulCriteria(
            true="the field is wrongly empty, null, or missing a value the source supports",
            false="the field captures the value the source supports",
        ),
    ),
    "format_violation": (
        "Does the `extracted_field` violate the format or constraints implied by the `description`, "
        "the schema `type`, and the extraction instructions (e.g. date format, units, enum membership)?",
        NoulCriteria(
            true="the `extracted_field` violates the implied format or constraints",
            false="the `extracted_field` satisfies the format and constraints",
        ),
    ),
}
ABSENCE_QUESTION = (
    "The `extracted_field` is empty, null, or an empty collection. Does the source text contain the "
    "information the `field_spec` describes, making the empty result wrong?"
)
ABSENCE_CRITERIA = NoulCriteria(
    true="a value was wrongly omitted", false="returning nothing is correct"
)

OVERALL_JUDGE = (
    "Is this extracted record an incorrect extraction -- some value unsupported by the source or "
    "not conforming to the schema, required information missing or wrong, or some field hallucinated -- "
    "so it should be escalated to a smarter model?"
)
OVERALL_JUDGE_CRITERIA = NoulCriteria(
    true="the record is an incorrect extraction",
    false="the record is a correct extraction",
)


def is_empty(v) -> bool:
    return v is None or (isinstance(v, (str, list, dict)) and len(v) == 0)


def field_spec(name: str) -> dict:
    """Minimal spec pulled from the schema (unwrapping anyOf/null for optional fields)."""
    p = schema["properties"][name]
    branches = p.get("anyOf") or []
    typ = p.get("type") or next(
        (b["type"] for b in branches if b.get("type") != "null"), "unknown"
    )
    return {
        "path": name,
        "type": typ,
        "description": p.get("description", ""),
        "required": name in schema.get("required", []),
    }


def build_questions(record: dict) -> dict[str, Noul]:
    """The verify question set: one holistic __overall__ head plus a per-field battery,
    keyed field::metric."""
    questions: dict[str, Noul] = {
        "__overall__::judge": Noul(
            instructions=OVERALL_JUDGE, criteria=OVERALL_JUDGE_CRITERIA
        ),
    }
    # Loop over the schema, not the record, so a field the extractor left out still gets asked.
    for name in schema["properties"]:
        value = record.get(name)
        spec = field_spec(name)
        if is_empty(value):
            questions[f"{name}::absence_wrong"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": ABSENCE_QUESTION,
                },
                criteria=ABSENCE_CRITERIA,
            )
            continue
        for metric, (question, criteria) in MAIN_QUESTIONS.items():
            if metric == "type_mismatch" and spec["type"] == "unknown":
                continue
            questions[f"{name}::{metric}"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": question,
                },
                criteria=criteria,
            )
    return questions


@json_cache
def verify(record: dict) -> dict[str, float | str]:
    """Run the whole Noul battery over a record in one TypeSafe call; return {field::metric: P(true)}."""
    state = {
        "system_message": EXTRACT_SYSTEM,
        "instruction": "Extract the structured record from this document",
        "source_text": content,
        "schema": schema,
        "extraction": record,
    }
    questions = build_questions(record)
    answers = ts.system_one(state=state, questions=questions, model=TS_MODEL).answers
    return {qid: ans.noul for qid, ans in answers.items()} | {
        "playground_link": make_playground_link(state, questions)
    }


checks = verify(mini_record)
playground_link = checks.pop("playground_link")
print("playground link ready:", playground_link[:60], "...")
print(f"{'qid':<40}{'P(wrong)':>9}")
print("-" * 50)
for fld, p in sorted(checks.items(), key=lambda c: -c[-1]):
    flag = "  <== FIRES" if p > FIRE_T else ""
    print(f"{fld:<40}{p:>9.2f}{flag}")
شغّل. إذا ضُبط TYPESAFE_API_KEY فسيُرسل فعليًا طلب Jev واحدًا (مجموعة الأسئلة بالتوازي، ذهاب وعودة واحد)، وتدخل الإجابات في الكاش.
يجب أن ترى (تسجيل رسمي):
qid                                      P(wrong)
--------------------------------------------------
description::hallucinated                    0.98  <== FIRES
description::off_target                      0.97  <== FIRES
__overall__::judge                           0.90  <== FIRES
description::unreasonable                    0.86  <== FIRES
description::incomplete                      0.54
description::name_desc_mismatch              0.46
description::format_violation                0.41
registration_open_date::absence_wrong        0.05
description::type_mismatch                   0.04
** الحقول الخاطئة فقط حصلت على درجات عالية **: الرؤوس الثلاثة لـ description تجاوزت خط الإنذار (اختلاق 0.98 / غير في محله 0.97 / غير منطقي 0.86)؛ وحقل التاريخ الفارغ صحيح، وabsence_wrong لديه فقط 0.05 — Jev لم يظلمه لمجرد أنه فارغ. __overall__::judge أيضًا أبلغ عن 0.90، لكنه ** لا يستطيع أن يقول أي حقل أخطأ ولماذا ** — أبقاه المسؤولون للمقارنة فقط بين «سؤال واحد كبير للسجل كاملًا» و«مجموعة أسئلة حقلًا بحقل»؛ ما يحدد الترقية فعليًا هو مجموعة الأسئلة حقلًا بحقل.
في بناء مجموعة الأسئلة ثلاث نقاط أخرى تستحق التوقف عندها:
| نقطة التصميم | الطريقة | لماذا |
|---|---|---|
| 7 رؤوس أوضاع الفشل | hallucinated / off_target / unreasonable / incomplete / name_desc_mismatch / type_mismatch / format_violation | اختلاق، غير في محله، إغفال، مخالفة لاسم الحقل أو وصفه، مخالفة النوع، مخالفة الصيغة — أي حقل غير فارغ يُسأل عنها جميعًا (يُتخطى type_mismatch عند كون type مجهولًا) |
الحقول الفارغة تُسأل فقط عن absence_wrong | القيمة الفارغة ليس لها «محتوى»، والخطأ الوحيد الممكن هو «النص الأصلي فيه معلومة فعلًا، وكونه فارغًا خطأ» | مستخرج يريد اختلاق قيمة ويترك الحقل فارغًا، سيمسكه هذا الرأس أيضًا |
حلقة على schema["properties"] وليس على record | الحقول التي ** أغفلها ** المستخرِج تُسأل كذلك | الحلقة record بـ record ستجعل «الحقل المفقود» يفلت كـ «غير مفحوص» |
يستخدم instructions للأسئلة كله كائنات مهيكلة — field_spec (الحد الأدنى من المواصفات يسحبه الكود من schema)، وextracted_field، وmain_question كل في حقل مستقل: السؤال مفصول عن البيانات التي يشير إليها، وتبديل حقل يبدّل البيانات فقط دون إعادة كتابة السؤال (لاستخدام التعليمات المهيكلة انظر أسئلة Noul بنعم/لا). والـ state أيضًا مهيكل بخمسة حقول: system_message / instruction / source_text / schema / extraction — يرى المدقق ** السياق الكامل وقت الاستخراج **، بما في ذلك رسالة النظام آنذاك.
💡 هذه هي القيمة الفريدة لـ Jev
ما يعطيه المدقق ليس نصًا «يبدو مدققًا»، بل ** P(حدوث مشكلة) معايَر ** — رقم واحد لكل حقل ولكل وضع فشل، قابل للترتيب ولوضع العتبات ولرسم المنحنيات. noul احتمالات متوائمة مع النتائج الحقيقية (هذه هي طريقة تدريب TypeSafe، انظر Jev ما هو )، والفجوة بين 0.98 و0.05 هي فجوة «هذا أمسكته» و«هذا لا يُظلم». اطلب من LLM عادي «أن يفحص»، وسيعطيك جملة مثل «الوصف يبدو غير دقيق» — لا رقم، ولا اسم حقل، وبالتأكيد لا سبب.
- جدول التحقق طابق الأرقام الرسمية؛ وأستطيع أن أقول أي الرؤوس الثلاثة أطلقها
description، ولماذاabsence_wrongالخاص بـregistration_open_dateمنخفض
الخطوة 5: المستوى الثالث — بوابة any_flag، ترقية إلى نموذج الاستدلال فقط عند إنذار سلسلة النماذج
**لماذا **: جدول التحقق أعطى تسعة أرقام، لكن «متى نُرقّي» يجب أن يكون خطًا صريحًا في الكود. البوابة الرسمية تسمى any_flag: ** تجاوز أي ** رأس حقلًا بحقل لـ FIRE_T يعني الترقية — ** نأخذ max، لا المتوسط **. لو أخذنا المتوسط، لخفّض العلم الأحمر 0.98 بدرجات الرؤوس الأخرى المنخفضة إلى ما دون خط الإنذار، و«يُسكت» إنذار واثق بالمتوسط.
كي تعمل عتبة واحدة، الشرط هو ذلك الفصل الذي في الخطوة 4: الحقول الخاطئة درجاتها عالية والحقول الصحيحة درجاتها منخفضة. وهذا الحساب يُحسب أيضًا في هذه الخطوة — يقول المسؤولون صراحةً ** يجب أن يكون المدقق أرخص بكثير من درجة الاستدلال، وإلا فلن توفر السلسلة شيئًا **: تدفع لكل سجل «mini + تحقق»، وإنما السجلات المنذَّرة وحدها تدفع تكلفة الاستدلال — بهذا الهيكل تصبح العملية مجدية.
# any_flag is a per-field gate: the holistic __overall__ head is shown above but not part of it
fired = {
    qid: p
    for qid, p in checks.items()
    if not qid.startswith("__overall__") and p > FIRE_T
}
escalate = bool(fired)

print(
    f"any_flag gate (threshold {FIRE_T}): {'ESCALATE' if escalate else 'ACCEPT cheap result'}"
)
for qid, p in sorted(fired.items(), key=lambda c: -c[1]):
    print(f"  fired: {qid}  (P={p:.2f})")
شغّل python sde_cascade.py. البوابة كود خالص، لا ترسل طلبات.
يجب أن ترى (تسجيل رسمي):
any_flag gate (threshold 0.7): ESCALATE
  fired: description::hallucinated  (P=0.98)
  fired: description::off_target  (P=0.97)
  fired: description::unreasonable  (P=0.86)
الأعلام الثلاثة المُطلقة كلها تشير إلى description؛ أما 0.90 الخاص بـ __overall__::judge فمستبعد صراحةً — للمقارنة فقط، لا يدخل البوابة. عند الإنذار تُدفع تكلفة الاستدلال: gpt-5.5 مع reasoning_effort="high" يعيد سحب هذا السجل؛ والسجلات غير المنذَّرة تستخدم نتيجة mini مباشرة.
final_record = (
    extract(REASONING, prompt, schema, content, reasoning_effort="high")
    if escalate
    else mini_record
)

print("mini      :", json.dumps(mini_record))
print("reasoning :", json.dumps(final_record))
print("\nfield-level diff (mini -> final):")
for name in mini_record:
    if mini_record[name] != final_record.get(name):
        print(f"  {name}: {mini_record[name]!r}  ->  {final_record.get(name)!r}")
شغّل. إذا ضُبط OPENAI_API_KEY فسيُرسل فعليًا طلب استدلال واحد، وتدخل الإجابة في json_cache.json.
يجب أن ترى (تسجيل رسمي):
mini      : {"registration_open_date": "", "description": "Registration opens for the fall semester"}
reasoning : {"registration_open_date": "", "description": ""}

field-level diff (mini -> final):
  description: 'Registration opens for the fall semester'  ->  ''
diff فيه سطر واحد فقط: ** نموذج الاستدلال رمى description المختلَق ** واستبدله بسلسلة فارغة — رأى أن الصفحة لم تصف تاريخ التسجيل أبدًا، ورفض أن يخترع. registration_open_date سلسلة فارغة في الجانبين، لم يُمسّ. دفعت السلسلة تكلفة الاستدلال على هذا السجل، وفعلًا لأن التحقق سمّاه.
- البوابة تطبع
ESCALATE، والأعلام الثلاثة المطلقة تطابق الرسمي؛ وفي diff أصبحdescriptionسلسلة فارغة؛ وأستطيع أن أقول لماذا نأخذ max لا المتوسط، ولماذا__overall__::judgeلا يدخل البوابة
الخطوة 6: فهم منحنى التكلفة/الجودة للـ 100 سجلًا الرسمي
لماذا:FIRE_T = 0.7 ليس رقمًا مُختلقًا. شغّل المسؤولون نفس الحلقة (extract → verify → escalate، gpt-5.4-mini → gpt-5.5-reasoning، بوابات any_flag على رأس كل حقل) كاملةً على 100 مهمة استخراج لـ ScrapeGraphAI-100k: TypeSafe يعطي درجة تحقق لاستخراج الدرجة الرخيصة لكل مهمة، مع مسح عتبة البوابة من 0 إلى 1، وتُرسم كل عتبة كنقطة (تكلفة، جودة).
لاحظ المصدر: هذه نتائج اختبار داخلية رسمية، من جولة مستقلة سابقة — نموذج التحقق في تلك الجولة كان jev-1.12 (أمثلة هذه الصفحة تستخدم jev-1.14.0)؛ ودرجة الجودة هي الدرجة التي أعطاها LLM judge لكل استخراج (mean llm_judge على الرسم).
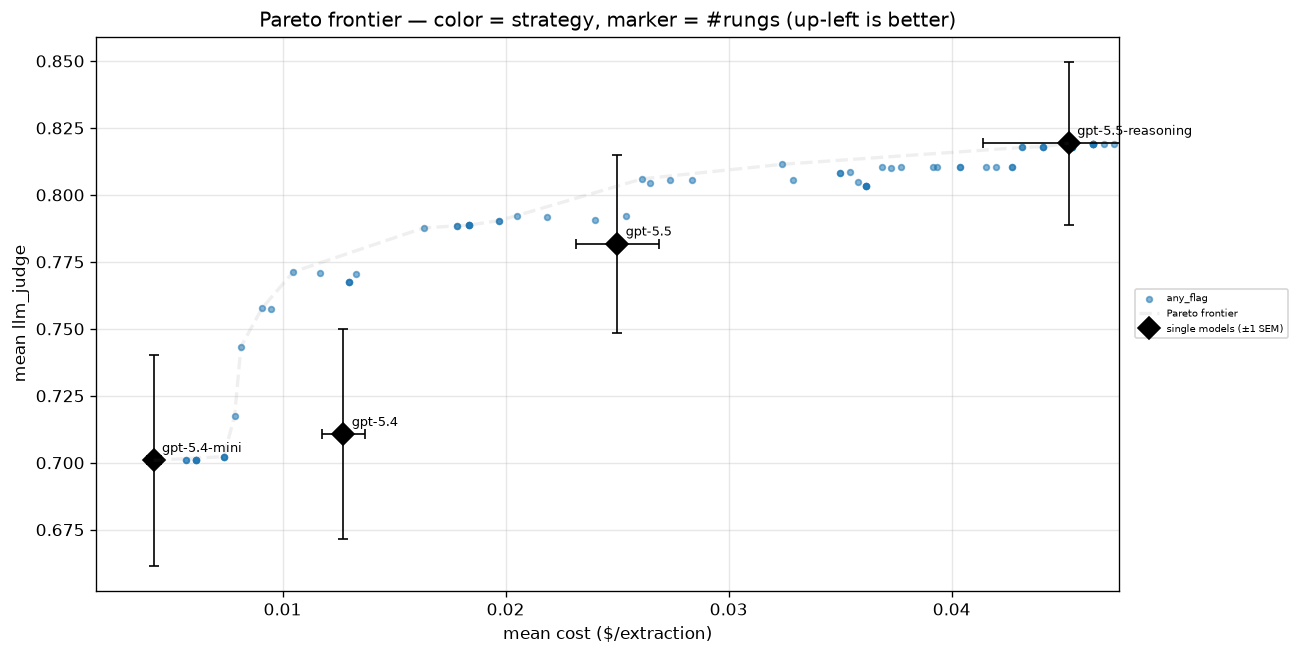
أربع قواعد للقراءة:
| عنصر الرسم | ما هو | كيف يُقرأ |
|---|---|---|
| المعيّن الأسود | كل نموذج من الأربعة يعمل منفردًا | التكلفة ترتفع مع القدرة؛ الأقوى gpt-5.5-reasoning في الزاوية العلوية اليمنى — الأغلى والأفضل |
النقاط الزرقاء (any_flag) | تكوينات السلسلة عند عتبات بوابة مختلفة كثيرة | كلما انخفضت العتبة زادت المهام المُرقّاة، وكلما ارتفعت قلّت؛ عتبة واحدة = نقطة واحدة |
| الخط المتقطع | جبهة pareto | ربط تكوينات السلسلة ذات أعلى جودة عند نفس التكلفة |
| موضع الجبهة | أعلى كل نموذج منفرد وإلى يساره | نقاط السلسلة تحقق نحو $0.02/مهمة بنحو 0.79؛ gpt-5.5-reasoning منفردًا يحقق 0.82 بنحو $0.045 |
بعبارة واحدة: جبهة السلسلة تضغط أعلى كل نموذج منفرد وإلى يساره — الدرجة الرخيصة تتخلص من المهام السهلة، ولا تُدفع نقود الاستدلال إلا للمهام التي رُفعت أعلامها، لذا فالجودة أعلى عند نفس التكلفة والتكلفة أقل عند نفس الجودة. 0.7 ليس رقمًا سحريًا، إنه مجرد نقطة واحدة على خط المسح 0→1؛ أين يجب أن تثبّت مهامك أنت، يتقرر بمسح بياناتك الخاصة أولًا (طريقة المسح موجودة في الـ Prompt السحري).
- أستطيع أن أشير إلى جبهة pareto على الرسم الرسمي، وأن أقول ماذا يعني «أعلى وإلى اليسار»، وأن أربط مجموعتي الأرقام 0.79 / $0.02 و0.82 / $0.045 بالنقطة المقابلة لكل منهما
📋 الـ Prompt السحري
«الـ Prompt» في هذه الصفحة هو أسئلة وقوالب كود مُعدّة لواجهة الـ API — انسخها، واستبدل العناصر النائبة 【】 (التي تحمل ? اختيارية) لتوصيلها بمهام الاستخراج الخاصة بك. ثلاث قطع: مجموعة أسئلة التحقق لكل حقل، بوابة any_flag، مسح العتبة.
📝 مجموعة أسئلة التحقق لكل حقل (نسخة Noul)
الأثر المتوقع: أي مهمة «ينتج فيها نموذج رخيص سجلات JSON ويلزم تدقيقها حقلًا حقلًا» — معاملات منتجات، إعلانات توظيف، قوائم عقارات — نفس مجموعة الأسئلة تصلح مع تغيير الـ schema فقط، والأعلام تسمّي الحقل + السبب.
# 必填项:【schema】你的 JSON Schema(字段 description 写清格式与示例);【记录】便宜模型的输出
#         失败模式头逐字抄官方七连:name_desc_mismatch / type_mismatch / unreasonable /
#         hallucinated / off_target / incomplete / format_violation
MAIN_QUESTIONS = {
    "hallucinated": (
        "Is the `extracted_field` unsupported by, or absent from, the source text?",
        NoulCriteria(
            true="the `extracted_field` is a hallucination -- not supported by, or absent "
            "from, the source text",
            false="the `extracted_field` is supported by the source text",
        ),
    ),
    【其余失败模式】: (
        【同一句式:这个字段是不是犯了这种错?】,
        NoulCriteria(true=【犯了这种错的描述】, false=【没犯的描述】),
    ),
}
ABSENCE_QUESTION = (
    "The `extracted_field` is empty, null, or an empty collection. Does the source text "
    "contain the information the `field_spec` describes, making the empty result wrong?"
)
# 选填项:按业务加头——单位、币种、语言、时效;某头总误报先改措辞再调线?
# 输出规范:qid 取 f"{字段名}::{失败模式}";true 一律 = 出问题,noul 就是 P(出问题)
# 约束条件:
# ✅ 循环 schema["properties"] 而不是记录——提取器漏掉的字段照样被问到
# ✅ 空字段只问 absence_wrong;type 未知跳过 type_mismatch
# ❌ 不要拿一道「这条提取对吗」的大题代替题组——大题说不出哪个字段、哪种错
✅ بوابة any_flag (نسخة كود)
الأثر المتوقع: منطق الإنذار سطر كود خالص — أي رأس لحقل يتجاوز الخط يُرقّى إلى النموذج الغالي، والمهام بلا إنذار تمر مباشرة بنتيجة النموذج الرخيص.
# 必填项:【FIRE_T】报警线(官方示例 0.7;上线前用自己的数据扫一遍再定)
fired = {
    qid: p
    for qid, p in checks.items()
    if not qid.startswith("__overall__") and p > 【FIRE_T】
}
escalate = bool(fired)
final_record = (
    extract(【贵模型】, prompt, schema, content, reasoning_effort="high")
    if escalate
    else mini_record
)
# 选填项:逐头设线——官方明说每道题可单独调阈值,编造类从严、格式类从松?
# 输出规范:fired 字典就是审计日志——哪个字段、哪种病因、多大概率
# 约束条件:
# ✅ 取 max 不取平均——一个自信的红旗不能被低分稀释成沉默
# ✅ 解析失败的记录当空记录进核查——每个字段读作缺失,报警升级,方向安全
# ❌ 别把 __overall__::judge 门进门控——它只作对照,决定升级的是逐字段头
🔧 مسح العتبة (نسخة اختيار نقطة العمل)
الأثر المتوقع: لا تخترق 0.7 اعتباطًا — خذ دفعة مهام وامسح العتبة من 0 إلى 1، وسجّل لكل عتبة نقطة (تكلفة، جودة)، وارسم جبهتك الخاصة ثم ثبّت نقطة العمل.
# 必填项:【任务集】一批提取任务(官方用 100 条 ScrapeGraphAI-100k);【打分】质量分怎么算
for fire_t in [i / 10 for i in range(11)]:        # 0.0 -> 1.0
    total_cost = total_quality = 0.0
    for item in 【任务集】:
        record = extract(【便宜模型】, item.prompt, item.schema, item.content)
        checks = verify(record)                    # 每条一次核查
        fired = any(
            p > fire_t for qid, p in checks.items()
            if not qid.startswith("__overall__")
        )
        final = extract(【贵模型】, item.prompt, item.schema, item.content,
                        reasoning_effort="high") if fired else record
        total_cost += 【便宜模型单价 + 核查单价 +(fired 时的贵模型单价)】
        total_quality += 【质量分:官方用 LLM judge 给每条提取打分】
    point = (total_cost / len(【任务集】), total_quality / len(【任务集】))
# 选填项:质量分用人工抽检代替 LLM judge,先抽 20 条看头的分离度?
# 输出规范:一张(成本, 质量)散点图;工作点钉在你预算线与前沿的交点
# 约束条件:
# ✅ 扫描和上线锁同一个核查版本 ID——别用会漂移的 jev-latest
# ✅ 先确认头的分离度(错字段高、对字段低),分离不开什么阈值都白搭
# ❌ 别把官方 0.79 / $0.02 当你的预期——那是 ScrapeGraphAI-100k + jev-1.12 那一轮的数字
نقاط تحقق ✅
- بوابة الخطوة 5 تطبع
ESCALATE، والثلاثة المُطلقة تتطابق مع التسجيل الرسمي؛ إعادة سحب الاستدلال تستبدلdescriptionبسلسلة فارغة، والـ diff سطر واحد فقط - أستطيع أن أقول تقسيم الأدوار في هذه السلسلة ثلاثية المستويات: mini للاستخراج، Jev للتحقق (طلب واحد)، ولا تُدفع نقود استدلال
gpt-5.5إلا عند الإنذار - أعرف لماذا تأخذ البوابة max لا المتوسط، ولماذا
__overall__::judgeيُستخدم للمقارنة فقط ولا يدخل البوابة - أستطيع أن أشرح لماذا «فشل التحليل يعيد
{}» هو الاتجاه الآمن: كل حقل يُقرأ كغائب → تحقق يُنذر → البوابة تُرقّي - أستطيع أن أشير على رسم الـ 100 مهمة الرسمي إلى جبهة pareto، وأن أقول ما هي 0.79 / $0.02 وما هي 0.82 / $0.045، وأن 0.7 مجرد نقطة على خط المسح
تنبيهات من العثرات
❌ البوابة تأخذ المتوسط، فتُميّع الأعلام الحمراء
any_flag بوابة من نوع max، والمسؤولون شدّدوا عمدًا على أنها «ليست متوسطًا»: علم أحمر واحد واثق يكفي للترقية، بدلًا من أن يُميّعه متوسط صفٍّ من الرؤوس منخفضة الدرجات. في مثال هذه الصفحة description::hallucinated يبلغ 0.98، وأدنى رأس لا يتجاوز 0.04 — بالمتوسط، هذا السجل المُختلق يقع تحت الخط ومع ذلك يدخل القاعدة؛ بـ max، يُضبط فورًا. عندما يكون فصل الأعلام جيدًا (الحقل الخطأ مرتفع والصحيح منخفض)، يكون max أكثر البوابات حساسية.
❌ إدخال __overall__::judge في حساب البوابة أيضًا
في كود البوابة not qid.startswith("__overall__") استبعاد صريح. ترك المسؤولون هذا السؤال الكبير للمقارنة بين «سؤال واحد للسجل كاملًا» و«مجموعة أسئلة لكل حقل»: إنه يعطي 0.90، لكنه لا يستطيع قول أي حقل خطأ ولماذا. ما يقرر الترقية هو دائمًا رؤوس الحقول — قيمة العلم في «الحقل + السبب»، فمن الطبيعي أن تبوَّب البوابة على الأعلام.
❌ تفعيل المخرجات المنظمة / JSON mode للاستخراج «منعًا للأخطاء»
كلا الدرجتين تستخدمان ردودًا نصية خالصة، وسبب المسؤولين غير بديهي: الأخطاء التي تريد هذه السلسلة ضبطها هي أخطاء متوافقة مع الـ schema. فك الترميز المقيّد يضمن صحة الشكل، لكنه يخفي النموذج الذي «يكسر الـ schema بسبب قراءة خاطئة للصفحة»، فيترك التحقق بلا سند؛ أما أخطاء الشكل السيئ فيوقفها jsonschema بسطر واحد. تسليم عمل التحقق الدلالي إلى فاكّ الترميز يعني إفلات أخبث الأخطاء والاحتفاظ بأوضحها.
❌ المُحقِّق ليس أرخص من نموذج الاستدلال، فتضيع فائدة السلسلة
قال المسؤولون بوضوح قاطع: يجب أن يكون المُحقِّق أرخص بكثير من درجة الاستدلال، وإلا فلن توفر السلسلة فلسًا واحدًا. حساب هذه البنية: لكل مهمة تُدفع «استخراج رخيص + تحقق واحد»، ولا تُدفع نقود الاستدلال إلا للمهام المُنذَرة. إذا ساوى سعر المُحقِّق سعر الاستدلال، فأنت عمليًا دفعت سعر الاستدلال لكل مهمة، والمهام المُنذَرة دفعت نسخة إضافية. على منحنى الـ 100 مهمة الرسمي تنخفض السلسلة إلى نحو $0.02/مهمة، والفضل لكون التحقق أرخص بكثير + أغلب المهام لا تُنذر.
تقنيات متقدمة (اختيارية)
أضِف واحذف في رؤوس أنماط الفشل. قال المسؤولون صراحةً إن كل سؤال يمكن تعديل صياغته وعتبته كلٌّ على حدة — مجموعة الأسئلة مجرد قاموس، وإضافة رأس تعني إضافة سطر. سباعية المسؤولين أنماط فشل عامة؛ إذا كان لمجالك أمراض خاصة (وحدات، عملات، لغات، تواريخ صلاحية) فأضف رؤوسًا لها. قبل تعديل الأسئلة تذكّر النقطة التالية: تعديل الأسئلة لا يُبطل الكاش.
تعديل الأسئلة لا يُبطل الكاش، وحذف الملف هو ما يجعلها تعمل فعلًا. مفتاح JsonCache هو اسم الدالة والوسائط فقط — بنص وثيقة cooksafe: تعديل جسم الدالة لا يُبطل المدخلات الموجودة. مجموعة أسئلة verify تُبنى داخل جسم الدالة، فتعديل صياغة MAIN_QUESTIONS أو إضافة رؤوس لا يغيّر مفتاح الكاش، والأجوبة القديمة تُعاد كما هي؛ لجعل الأسئلة الجديدة تُطلب فعلًا، احذف json_cache.json أولًا. ضبط FIRE_T غير متأثر — البوابة كود خالص ولا يمر عبر الكاش.
جرّب مجموعة أسئلة التحقق الرسمية مجانًا. SDE cascade cookbook الرسمي أرفق أسفل مخرجات التحقق روابط مشاركة Playground جاهزة — مجموعة أسئلة الخطوة 4 مع الحالة الكاملة لـ example.json، بنقرة واحدة تعدّل الصياغة في المتصفح وترى توزيع الاحتمالات. لتوليد روابط لسجلاتك أنت، make_playground_link(state, questions) في كود الخطوة 4 جاهز مسبقًا — الرابط يحمل الحالة الكاملة والأسئلة، ومن يحصل على الرابط يستطيع قراءتها، فلا تضع بيانات حساسة.
اربط هذا بخط الدفعات الخاص بك. المكونات الثلاثة كلها تتبع النمط «مخطط + محتوى دخلًا، سجلات + أعلام خرجًا»: استبدل المخطط بجدول حقولك، والمحتوى بالصفحات التي تجمعها، وأعد استخدام extract / verify / البوابة كما هي. بعد أن يعمل كل شيء لا تتعجل في تحديد العتبات — اجمع دفعة من البيانات وارسم منحنياتك الخاصة بأسلوب المسح في الخطوة 6، وثبّت نقطة التشغيل عند خط ميزانيتك.
خلاصة هذا الدرس
✅ تسلسل ثلاثي المستويات = استخراج رخيص + Jev فحص كامل + نموذج غالٍ كحل أخير: gpt-5.4-mini استخراج نصي خالص (مع تعطيل المخرجات المهيكلة عمدًا) → Jev طلب واحد يتحقق من كل حقل على حدة → any_flag التصعيد عند وجود إنذار فقط gpt-5.5 (reasoning_effort="high").
✅ الأعلام تسمّي الحقل + السبب: في المثال الرسمي، القيم الملفقة على description أطلقت ثلاثة إنذارات (0.98 / 0.97 / 0.86)، بينما الحقل الفارغ الصحيح absence_wrong لم يحصل إلا على 0.05؛ نموذج الاستدلال يرمي القيم الملفقة، والتسلسل لا يدفع تكلفة الاستدلال إلا للعناصر المسمّاة.
✅ البوابة تأخذ max لا المتوسط،__overall__ يعمل للمقارنة فقط: أي رأس لكل حقل يتجاوز FIRE_T يستدعي التصعيد؛ فشل التحليل يعيد {} وهو الاتجاه الآمن؛ وصحة هذه الحسابات تفترض أن المدقق أرخص بكثير من درجة الاستدلال.
✅ المنحنيات الرسمية الـ 100 تحدد نقطة التشغيل: حدود التسلسل فوق يسار كل نموذج منفرد — بنحو $0.02 لكل عنصر تحصل على نحو 0.79، بينما gpt-5.5-reasoning منفردًا يحقق 0.82 بتكلفة نحو $0.045؛ 0.7 ليست سوى نقطة واحدة على خط المسح، وامسح مهمتك بنفسك.
مراجعة حقول الإعداد الرئيسية:
| الحقل | القيمة في هذه الصفحة | الشرح |
|---|---|---|
MINI / REASONING | gpt-5.4-mini / gpt-5.5 (reasoning_effort="high") | درجتا استخراج، ردود نصية خالصة؛ تغيير النموذج يعني تعديل هذين السطرين فقط |
TS_MODEL | jev-1.14.0 | نموذج التدقيق؛ في الجولة الرسمية الـ 100 كان jev-1.12؛ في التشغيل المباشر اربط معرف الإصدار، ولا تستخدم jev-latest |
FIRE_T | 0.7 | any_flag خط الإنذار؛ رسميًا تم مسح 0→1 بالكامل لاختيار نقطة التشغيل |
| رؤوس أنماط الفشل | 7 + absence_wrong (إضافة إلى __overall__::judge للمقارنة) | مجموعة كاملة للحقول غير الفارغة، وللحقول الفارغة يُسأل absence_wrong فقط، ويُتخطى type_mismatch عند كون type غير معروف |
| التخزين المؤقت | json_cache.json | LLM + TypeSafe جميع الاستدعاءات تدخل ذاكرة التخزين المؤقت؛ تعديل الأسئلة لا يبطلها، وحذف الملف فقط هو ما يستدعي طلبات فعلية |
| عدد الطلبات لكل عنصر | 1 مرة mini + 1 مرة تدقيق (مجموعة الأسئلة بالتوازي) + 1 مرة استدلال تضاف عند الإنذار فقط | معظم العناصر تدفع تكلفة المستويين الأولين فقط |
دروس ذات صلة:
- استخراج القيم: التواريخ والبريد الإلكتروني والهاتف والمبالغ حرفيًا وبصورة صحيحة — نسخة الانتقاء الدقيق للحقل الواحد: Jev تنتقي القيمة بنفسها؛ أما عند تضخم الحجم فستحتاج إلى تقسيم العمل بالتسلسل كما في هذه الصفحة
- الأسئلة المتوازية والتوسع التخميني — الآلية الكامنة وراء «سؤال واحد لكل حقل ولكل نمط فشل، وطلب واحد يجيب عليها جميعًا»
- أسئلة Noul نعم/لا — نوع أسئلة التدقيق: تعليمات مهيكلة، true = وجود مشكلة، noul = P(true)
استعراض الدرس التالي
انتهينا من تدقيق سلسلة النصوص، فكيف نضبط الجودة على المستندات الممسوحة ضوئيًا وقراءات OCR؟ الدرس التالي: تطبيق عملي على الصور: قراءة المستندات الممسوحة والتحقق من نتائج OCR.
ستتعلم:
- خط معالجة قراءة المستندات الممسوحة: Noul يحدد هل الهدف موجود، Box يحدد أين هو، Choice يقرأ القيمة — التاريخ المغطى بملصق يُرجع
unreadable، لا سنة مُخمَّنة عشوائيًا - التدقيق على القيم المستخرجة من OCR: كل حقل يُفحص في الصفحة الكاملة مرة، ثم يُمعن النظر في الصورة المقصوصة مرة أخرى، وإذا انخفض عن 0.25 يُحوَّل إلى مراجعة بشرية، مع رسم إطار مراجعة على الصورة الأصلية
- نفس فكرة الضبط المعتمدة في هذه الصفحة «احتمالات معايَرة + عتبات في الكود» — غير أن موضوع التدقيق تغيّر من استخراج النصوص إلى قراءة الصور